知识库与工作流

给模型一本能翻的书,再把活儿拆成流水线
——原理讲透,参数直接抄

华电新疆公司 集团 AI 竞赛赛前培训 · 第四天 · 授课三(10:00-10:25)

中软国际  |  2026年10月22日
目 录
1、知识库:给模型一本能翻的书痛点与对策 → 怎么工作 → 怎么切 → 怎么查 → 一张配置表直接抄 → 查不到怎么办
2、工作流:把活儿拆成流水线五个节点跑通 → 三个零件一条铁律 → 放大到团体赛 20 节点 → 四个坑
3、拿到题怎么规划五步,全在纸上做完再上画布
4、转实操10:35 实操三 建库调参;16:35 实操四 分组搭工作流
中软国际 · 华电新疆公司集团 AI 竞赛赛前培训 · Day4 · 授课三02 / 17
01

知识库:给模型一本能翻的书

模型是个闭卷考生。知识库让它开卷:答题前先翻书,再照着书答。
这一节只讲三个旋钮——怎么切、怎么查、留几条。
痛点与对策怎么工作怎么切怎么查配置表查不到
参数不用背,从机制推;上机时对着配置表填就行。
中软国际 · 华电新疆公司集团 AI 竞赛赛前培训 · Day4 · 授课三03 / 17
知识库 · 痛点与对策

模型是个闭卷考生:没见过你单位的资料,只能编

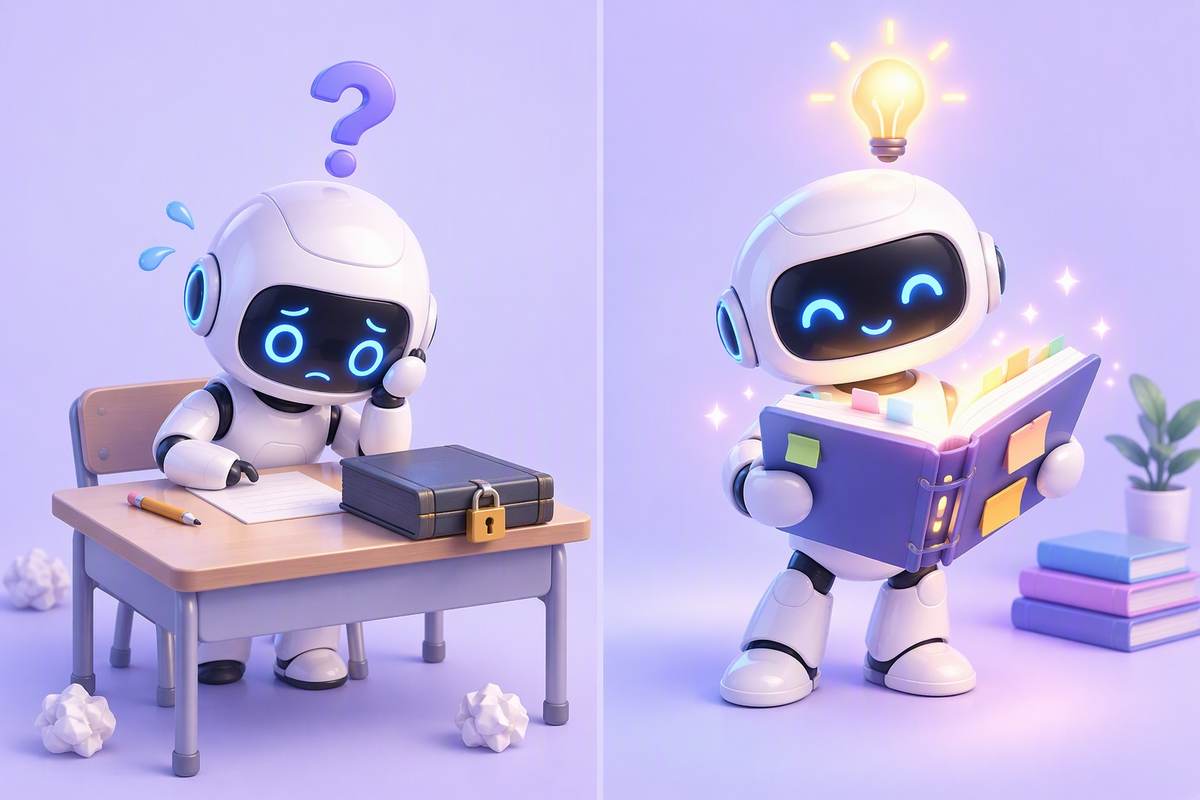
知识库 = 让它开卷。答题前先翻书,再照着书答,还能告诉你翻的是哪一页。

闭卷 vs 开卷
左:闭卷硬答,一本正经地编 | 右:开卷有依据,还能标出处
够不着你单位的资料
规程、审查规范、历史项目台账——训练时从没见过
够不着最新的事
知识停在训练那一天,上个月改版的规范它不知道
够不着精确的条款号和数字
记得“大概有这么个规定”,记不住第几条、限值多少
✕全贴进提示词有长度上限,资料一改就得重贴
✕重新训练模型贵、慢,条款号最容易记串
✓外挂知识库(RAG)资料放库里,答题前先查几段再答;换书不换模型
知识库不改模型,改的是模型答题前看到了什么。资料更新了,重新入库就行。
插画为课程绘制;RAG = 检索增强生成,课堂统一叫“知识库”。04 / 17
知识库 · 怎么工作

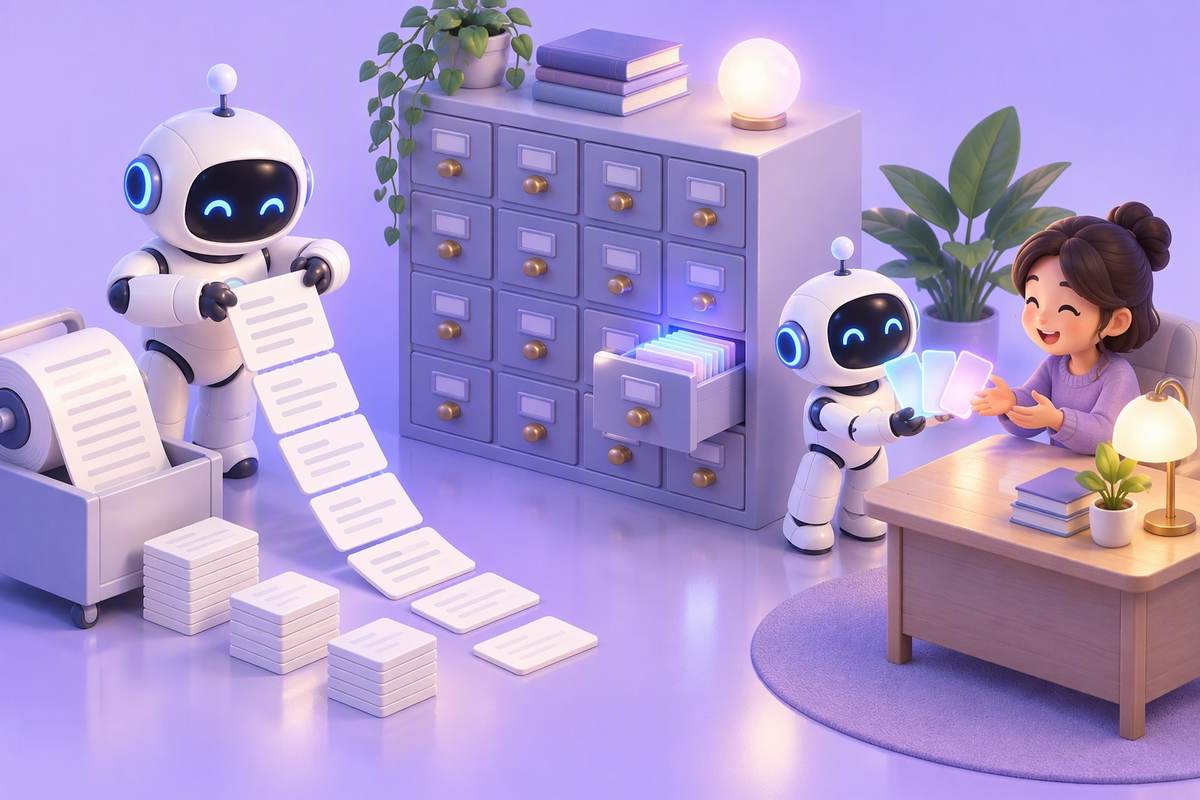
知识库像图书管理员:先做索书卡,提问时按卡取页

上一行建库时做一次,下一行每次提问都走一遍。红色的是你能拧的旋钮。

图书管理员比喻
把书拆成卡片归档,有人来问就抽出最相关的几张
建库时做一次把资料变成能被查到的卡片
读文档

PDF / Word 变文字

切片

长文切成一张张卡

转数字

意思相近→数字相近

入库

数字 + 原文一起存

每次提问走一遍只挑最相关的几张卡给模型
问题转数字

同一套算法

找最像的

按意思 + 按字面

排序留前几

Top K 条

照着答

卡片 + 问题一起给模型

你真正要管的只有三个旋钮:怎么切 · 怎么查 · 留几条。其余平台自动完成。
模型从头到尾没有学会你的资料,只是每次答题前被塞了几张卡。查不查得到,全看切得对不对、查得准不准。
流程为主流通用做法归纳;不同平台叫法略有差异。05 / 17
知识库 · 怎么切 ①

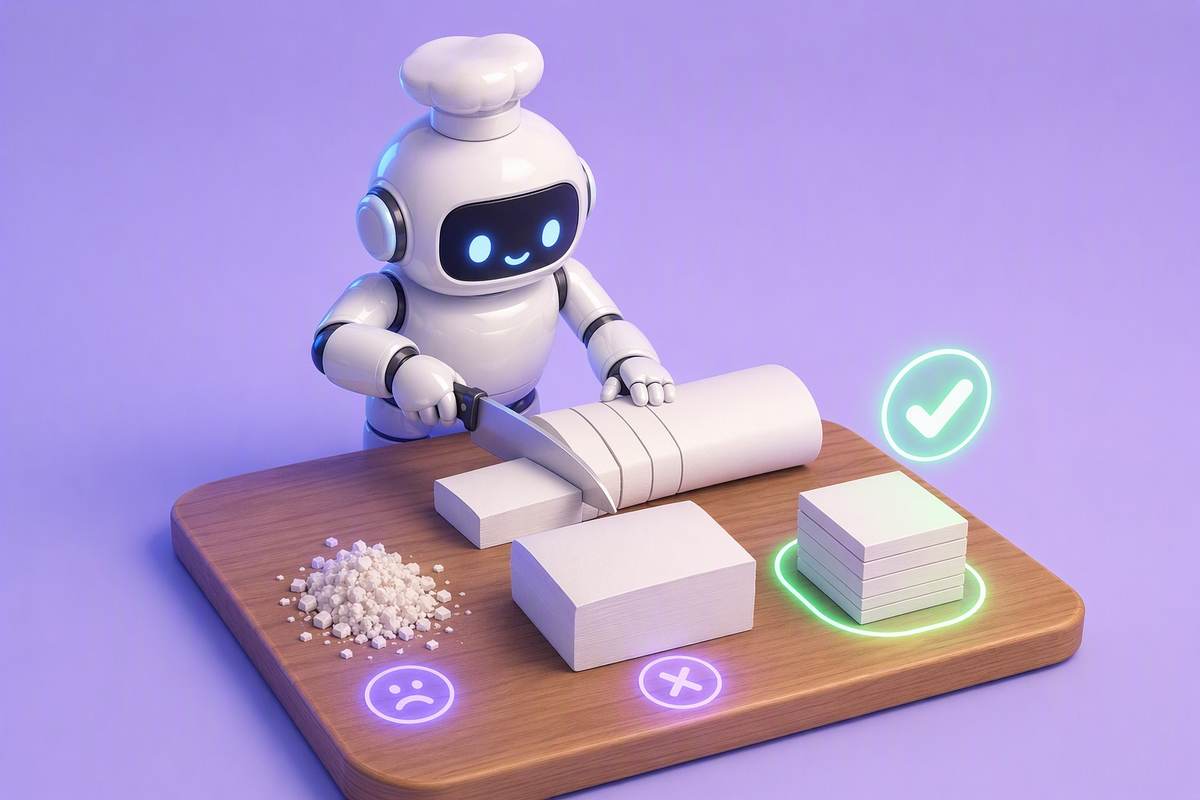
切片像切菜:太碎没味道,太大嚼不动

平台给三种切法。不是好坏之分,看文档长什么样来选。

切片比喻
碎末:查得准但没上下文 大块:有上下文但查不准 整齐薄片:刚好
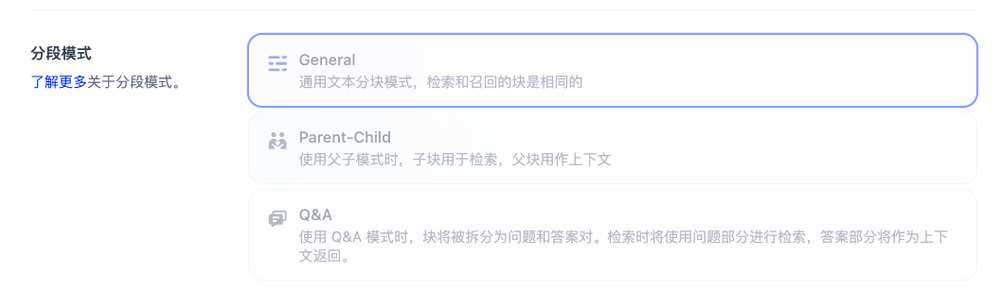
真实平台:三种分段模式
真实平台界面:分段模式就这三种(点图可放大)
通用General
按分隔符 + 固定长度一刀刀切,相邻块重叠几十字
没有结构的大段散文
父子Parent-Child
大块套小块:小块用来找,大块用来读
有章 / 条 / 标题层级的规范、手册
问答Q&A
模型自动拆成“问 + 答”:用问题找,返回答案
FAQ、规程问答类资料
口诀:有编号层级 → 父子;问答形态 → 问答;什么结构都没有 → 通用。分隔符、长度、重叠是模式里的参数,不是第四种模式。
三种模式名称取自真实平台界面;分段设置的逐步点击见实操三手册 3.1。06 / 17
知识库 · 怎么切 ②

切多大、重叠多少:照这张表填,再看预览块

单位是“字”,不是 token。中文从 500 起步,看预览块再微调。

文档长什么样分段长度(字)这样定的理由
FAQ、产品手册、术语表200 ~ 400一问一答短,切小查得准
规范条文、检修规程(本课)500 ~ 800一块 = 一条完整规定,引用时条号和内容对得上
书籍章节、长篇论述800 ~ 1500要保留完整论证逻辑
重叠 = 相邻两块共享的字数,取长度的 10% ~ 25%
第一段 1 ~ 500 字
第二段 451 ~ 950 字
黄色那截就是重叠的 50 字——防止关键一句正好被切在边界上丢掉;这是「通用」模式的参数。父子模式没有重叠输入框:子块本身就带着父块当上下文,不需要再重叠。
父子分段
父子分段:小卡精准定位,整个文件夹补全上下文
命中子块时返回子块 + 父块:模型既看到精确的那一条,也知道它属于哪一章。本课三份文档都用父子:父 \n\n/2000,子 \n/500。分隔符填空行和换行,不填 ##——平台入库时先去掉 # 号,标题符匹配不到。
切完再看一眼预览块:这一块单独拿出来敢不敢直接当依据引用,不敢就是切错了——改完分段要重新处理文档。
长度区间参考公开 Dify 实践经验与课程调试;示例数字为课堂虚构。07 / 17
知识库 · 怎么查

两种找法:按意思找、按字面找——所以要“混合检索”

各管一类查询,谁也替代不了谁。懂了这条,权重才知道往哪边调。

语义与关键词的天平
左盘:意思(语义) 右盘:字面(关键词) 调权重 = 挪天平

按意思找(语义)

问:人工费最多能占多少?
查到:人员费用占总经费比例不得超过 40%
一个字都不重合,照样找到——换个说法也行
换说法查不到 → 语义权重调到 0.6

按字面找(关键词)

问:第 3.0.3 条说了什么?
查到:第 3.0.3 条 ……(一击即中)
只按意思找:会把 3.0.1、3.0.2、3.0.4 一起捞回来
条款号查不准 → 关键词权重调到 0.6
语义 0.5关键词 0.5
← 换说法查不到:语义调到 0.6条款号查不准:关键词调到 0.6 →
换个说法还能找到,靠语义;编号、条款号、专有名词精确命中,靠关键词。两路同时找,再重排一次,就是混合检索。
示例文本为课堂虚构;滑块为 HTML 绘制示意,真实界面见实操三手册 3.2。08 / 17
知识库 · 一张表

推荐配置一张表,可以直接抄

九个设置项里,真正经常动的只有三个(红底):权重、召回条数、分数阈值。其余建库时定死。查询词以编号、费用类别为主的库(如台账库),建库时关键词权重直接给 0.6,见实操三第 5 节。

设置项起手填什么什么情况怎么调
索引方式高质量“经济”模式不建向量,按意思找直接失效
分段模式父子分段父 \n\n/2000,子 \n/500;取消"替换连续空格换行";FAQ 资料换问答模式
检索方式混合检索只查编号 → 全文;只查口语表述 → 向量
权重语义 0.5 / 关键词 0.5条款号查不准 → 关键词 0.6;换说法查不到 → 语义 0.6
重排 Rerank有就开环境没接重排模型 → 关,并把召回条数调小
召回条数 Top K10漏依据 → 15;无关段太多 → 6 ~ 8
分数阈值 Score检索时库里每一块都和查询词比一次,打 0~1 的相关度分,越像分越高。阈值是及格线:低于线的块,即使排进 Top K 也不要0.3 起步稳定后 0.5回答里一个条款号都没有 → 线太高把相关块拦在外面,调低到 0.2 或先关;引了不相干的内容 → 线太低杂块混进来,抬到 0.5
大模型温度0.2审查 0.2;抽取 0.1;概要 0.3;JSON / HTML 给 0——越要格式越不给发挥
系统提示词四段式角色 → 任务 → 回答规则(只用检索到的依据、标出处)→ 输出格式

在哪设

知识库设置里的是默认值;每个「知识检索」节点里可以单独覆盖。同一个库给多路检索用时,在节点里改比改库干净。

调参纪律

一次只动一个。动一个 → 跑一遍召回测试 → 再动下一个。同时改两个,好了坏了都不知道是谁的功劳。

原则宁多勿漏:多召回的噪声提示词能筛掉;漏掉的依据,模型只会用编的补上。
起手值综合公开 Dify 实践与团体赛参考架构(BM25 0.5 / 向量 0.5 / Top K 10);以本地部署版本界面为准。09 / 17
知识库 · 查不到

模型说“没找到依据”?别乱调参数,按四步看病

固定顺序、固定入口,两分钟定位到问题在哪一层。

排查比喻
先听诊(召回测试),再决定动哪里
1先做召回测试 知识库页右上角直接搜工作流用的那句查询词。搜得到 = 库没问题,是查询词写窄了;搜不到 = 往下走
2看分段 文档 → 设置 → 重新分段条款号和条文分家、表格被拦腰截断,改完重新处理才生效
3放宽检索 检索节点 / 库设置召回条数调大 → 阈值调低或先关 → 换混合 + 重排。一次只动一个
4看入库本身 知识库列表 · 状态列状态是不是「可用」、索引是不是「高质量」。一直“索引中”多半是向量模型没接上
召回测试是分水岭:库里搜得到、工作流搜不到 → 查查询词;库里就搜不到 → 别去碰工作流。建完库必做。
排查顺序为课程归纳;召回测试在部分平台叫「命中测试」。10 / 17
02

工作流:把活儿拆成流水线

知识库解决“依据从哪来”,工作流解决“这么多步怎么串”。
先用五个节点跑通一个问答,再放大到团体赛的十九个节点。

五个节点三个零件一条铁律放大到团体赛四个坑
学完这一节,看到任何一道题,应该能说出要几个节点、每个什么类型。
中软国际 · 华电新疆公司集团 AI 竞赛赛前培训 · Day4 · 授课三11 / 17
工作流 · 五个节点

零代码:五个节点就能跑通一个知识库问答

每个节点只干一件事,像流水线上的五个工位。先把这条最短的线搭通,再谈复杂的。
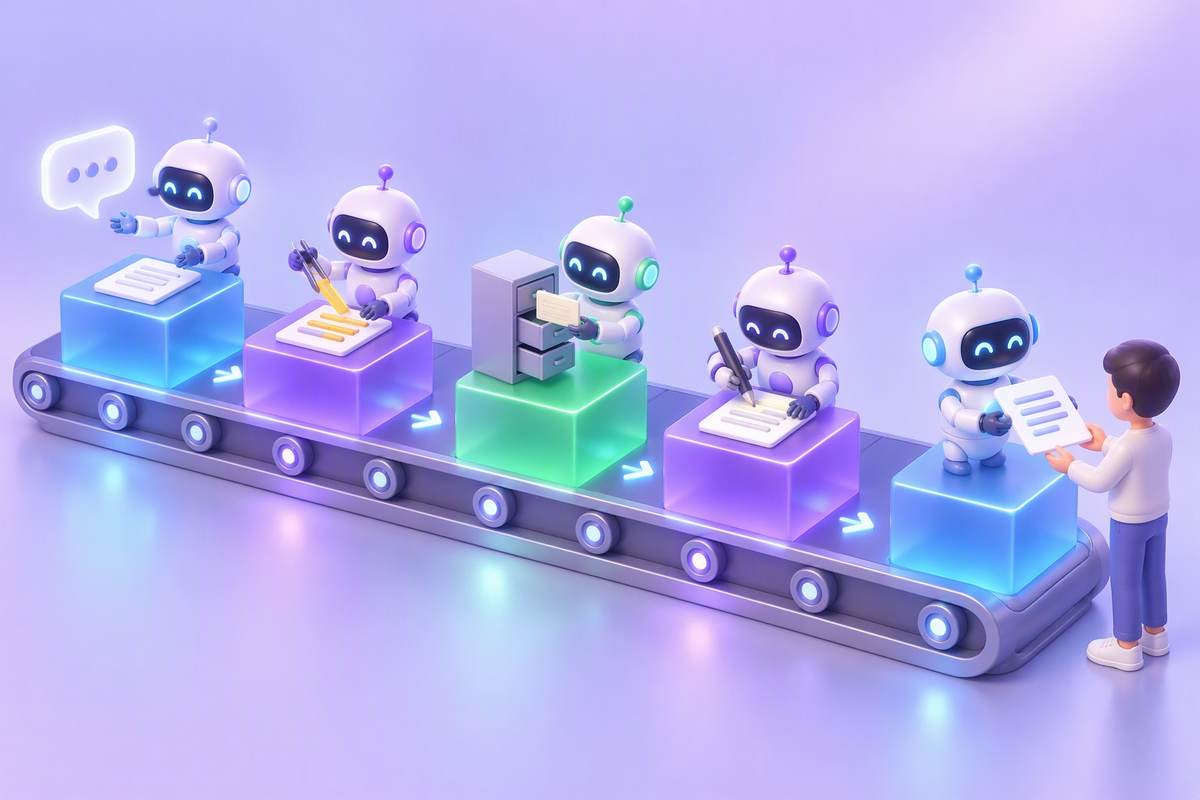
五个工位流水线
收问题 → 提炼关键词 → 查资料 → 照着资料写 → 交出去
开始
收问题

定义输入变量

大模型 ①
提炼关键词

提示词约束:只提炼、别直接答

知识检索
去库里找

选知识库 + 填查询变量

大模型 ②
照着资料答

检索结果挂“上下文”;只用依据、标出处

结束
交出去

只输出该输出的变量;工作流模式用「结束」不用「直接回复」

跑一遍后,每个节点的输入和输出都能点开看——哪一步出错一眼就知道,这是工作流比单条提示词最大的好处。
工作流的本质一句话:把大任务切成小步,一步只做一件事,步与步之间用变量传数据。
五节点结构参考公开 Dify Chatflow 教程;真实画布截图见第 14 页与实操四手册。12 / 17
工作流 · 零件与铁律

画布上只有三个零件,再加一条铁律

再复杂的工作流也是这三样堆出来的。铁律决定整条线可不可信。

节点 = 干活的一步

一个节点只做一件事。紫色是大模型、绿色是检索、蓝灰是输入输出。

连线 = 数据往哪流

同时决定谁等谁。没连上的节点,拿不到上游的东西。

变量 = 唯一的传话方式

长成 {{#节点名.字段#}}。上游改名,下游全部报错——变量名第一天就定死。

确定的事 → 交给代码节点
  • 算占比、算完成率、算差值
  • 比大小、判是否超过阈值
  • 查重、日期计算、单位换算
  • 校验必填、类型、取值范围
每次结果一样,可以验证——这是准确性的保障
要理解的事 → 交给大模型节点
  • 从一段散文里认出项目名、经费、周期
  • 判断这个创新点和历史项目算不算重复
  • 判断论证是否充分、方案是否可行
  • 把结论写成通顺、专业的分析意见
唯一能“读懂”的节点;输出格式必须在提示词里写死
✓模型抽数 → 代码算数 → 模型写话抽出 92 和 100 → 代码:92% < 95% 不达标 → 模型拿着确定结论写分析
✕“请算出完成率并判断是否达标”全交模型算错你看不出来;同样输入跑两次,一次达标一次不达标
凡是有标准答案的,都不要交给模型。模型负责“读懂”和“写出来”,代码负责“算对”。
变量写法以本地部署版本为准;示例数值为课堂虚构。13 / 17
工作流 · 放大到团体赛

团体赛参考架构 20 个节点,就是那五步的放大版

这张画布替电厂解决技改可研报告第一轮人工审查的痛点:慢、容易看漏、结论难追溯。规划完全顺着厂里现有的审查分工和公文要求来;看画布时找开始、找检索、找汇合、找出口。

① 提取 #1-3② 检索 #4-9③ 审查 #10-16④⑤ 汇总输出 #17-20开始doc_name · upload_file1文档提取器PDF → text2摘要抽取大模型 · 六类字段3检索 必要性混合检索 · TopK 104审查 必要性先结论再分析10检索 可行性混合检索 · TopK 105审查 可行性先结论再分析11检索 创新性混合检索 · TopK 106审查 创新性先结论再分析12检索 合规性混合检索 · TopK 107审查 合规性先结论再分析13检索 设计依据混合检索 · TopK 108审查 设计依据先结论再分析14检索 成本收益混合检索 · TopK 109审查 成本收益先结论再分析15语义一致性审查不查库 · 对照①~⑥与全文16语义一致性同时读抠出来的六类字段,做全文自检概要生成汇合点 · 温度 0.317JSON 输出切块 · 温度 018HTML 输出模板 · CSS 写死19结束只接 html20① 六路并行检索② 六个维度各判一维汇合点③ 固定格式交卷
输入 / 提取 ×2知识检索 ×6大模型 ×12输出 ×1按往届团体赛参考架构真实画布重绘(检索参数:BM25 0.5 / 向量 0.5 / Top K 10)
1六条业务线各判一维 → 工作流六路并行 厂里技改审查本来就分六条业务线:规划(必要性)、生产技术(可行性)、科技管理(创新性)、安环法务(合规性)、财务(成本收益)、基建运维(设计依据)。各线只看自己那一维、互不等 → 工作流就六路并行,耗时=最慢的一路
2结论要经得起审计倒查 → 先查书再写结论 审查结论要可追溯:审计和后评价会倒查“这条结论依据哪一款、哪一行台账”。所以每路先从库里捞条款和台账行,再写结论,结论里必须带编号——知识库利用 15 分就评这个
3对外只交一份意见 → 汇合点加第七个审查 对外交的是一份完整评审意见,不是六张纸;六路写完必须汇到“概要生成”。汇的时候再做第七个审查:语义一致性——同一笔设备费,不能成本线写合规、合规线写有风险
4评审意见是公文 → 模板把版式写死 评审意见是电力公司公文:标题方正小标宋、正文仿宋_GB2312,这套字体字号是单位公文规范。模板写死,模型不许即兴发挥
串并行的判据一句:后一步用到前一步的结果就串着跑;用不到就并排跑,最后汇合。
架构图按团体赛题干答案与解析资料中的参考画布重绘;节点详细配置见实操四手册第 4、5 节。14 / 17
工作流 · 四个坑

工作流崩了,九成是这四件事,不是模型不聪明

搭之前先记住,比崩了再回来找快得多。

① 变量断链
报“变量不存在”;上游改了名,复制的节点还指着旧名字
变量名在开始节点一次定死,写进团队约定表
② 输出格式飘了
这次规规矩矩,下次多写一句“好的,以下是……”,下游接不住
提示词写死“只输出规定结构”;下游加代码校验
③ 一个节点啥都干
又抽字段、又判断、又排版;提示词超过一屏,改一处整段重写
一个节点一件事,宁可多几个节点
④ 脏数据没人拦
文件解析失败、抽出空内容,一路流到最后,“看着像样内容是空的”
入口加条件分支:为空 / 缺字段 → 走报错或转人工
四个坑的防法其实是同一件事:在每个节点的出口,把“下一步能直接吃”当作硬性要求。
四类问题为教学与实操中反复出现的通用故障,与具体平台无关。15 / 17
规划 · 五步

拿到题先别上画布:五步在纸上做完

顺序不能颠倒——先定出口,才知道中间几步;先定节点,才知道数据怎么流。

纸上规划
纸上画完再上画布;三个人各拿一段,变量名先约定好
1圈输出 最终交什么、什么格式、给谁看从出口倒着推。只写“做一套审查系统”=后面每步都在猜
2列任务 一件事一句话,只写“要什么”不写“怎么做”,写到不能再拆为止
3定节点 有标准答案给代码,要理解给模型,要资料给检索产出:节点清单(名 / 类型 / 输入 / 输出)
4画数据流 谁给谁什么变量,哪几步能并行,在哪汇合每条线上都要能写出变量名
5定顺序与分工 先主线跑通 → 再接支路 → 最后全流程一人一段;每轮测试只改一处
节点清单填完,工作流已经搭了一半。表填不出来的那一行,就是你还没想明白的那一步。
五步法为课程归纳的通用规划方法;节点清单空白模板见实操四手册第 2 章。16 / 17

谢谢

10:35 上机《实操三 知识库搭建与检索研判》——对着第 9 页配置表逐项填,建完必做召回测试。
15:30 授课四《数据提取与指标计算 · 定时任务与保密》——代码节点、条件分支、模板转换怎么配。
16:35 上机《实操四 团体赛工作流分组搭建》——先用五步法填完节点清单,再上画布组装。

目录(点击跳转)