目录
0 开始之前:本节范围、素材、55 分钟节奏1 题目还原:知识库要替哪几个维度提供依据2 建库决策:为什么是三个库 + 总览表3 库① 审查规范库:逐项参数 + 召回测试4 库② 创新点汇编库:逐项参数 + 召回测试5 库③ 经费台账库:逐项参数 + 召回测试6 课堂分工与 55 分钟节奏表(只建库、只测召回)7 常见问题 / 自检 / 保密 / 下午怎么用这三个库 0 开始之前:本节范围、素材、55 分钟节奏本节只做一件事:把三个知识库建对、测对。 不开工作流画布——文档提取、摘要抽取、六路检索、七个审查、三道闸、概要 / JSON / HTML 全部在下午实操四。本节的交付物就三样:三个状态为「可用」的知识库、13 条召回测试记录、一张团队约定表(库名) 。下午实操四的六路知识检索节点直接勾这三个库,所以库建歪了下午全组都查不到依据。
和授课三的对应: 授课三讲了"怎么切、怎么查、留几条"三个旋钮;本节就是把这三个旋钮在三份真实文档上各拧一遍,并用召回测试证明拧对了。
为什么入库用 .md 不用 .docx: 分段要靠文档自己的结构。docx 转成文本后"章"和"条"只是普通段落;.md 版每章、每条之间都留了空行,父子分段用 \n\n(空行)就能一刀切对。真实比赛拿到 docx / pdf 时思路完全一样 :先把文档整理成"一条一段、段间空行",再入库。
平台实测(Dify 云端 2026-10,本地版同理): ① 上传 .md 后平台会把 # 标题符号去掉再分段,所以分段标识符里填 ##/### 匹配不到任何东西 ,整篇会变成一块;要用 \n\n(段落空行)和 \n(换行)。② 父子分段模式没有"重叠长度"这个输入框 ,重叠只在"通用"模式下有;手册里写的重叠 50 / 0 是通用模式的参数,父子模式忽略即可。③ 整篇文档比"父块最大长度"短时(规范全文 1255 字 < 2000),平台不会再切父块,预览里全部子块都标 C-1,这是正常现象,不是分段失败——判断是否切对看子块:一条一块即对。
55 分钟怎么过: 0-10 建库①(上传、父子分段、预览核对、索引);10-20 建库②③;20-40 三库召回测试,13 个查询词逐个对答案、填记录表;40-50 对不上的回去调分段 / 权重 / 阈值再测;50-55 填团队约定表。详细分工见第 6 节。三个库建完、13 条召回全命中,本节就算完成;下午实操四从这三个库起步。
素材性质: 全部文档为课堂自制虚构教学版,文件名已标注;不对应任何真实标准、企业或项目。课堂与作业不上传真实规程、真实可研、真实经费数据到任何外部服务。
1 题目还原:知识库要替哪几个维度提供依据题面给了六个审查维度,其中三个明文要求"检索知识库并输出依据",评分里知识库利用质量 15 分 单列。先把"哪个维度要查什么、查到后必须写出什么"抄清楚,才知道三个库该各放什么、切多细。
题面摘录(三个明文要查库的维度) 具体标准规范的名称与条例 )历史项目名称及对应创新点内容 )历史同类项目经费、成本收益数据 )引用的依据相关、准确 。
维度 要从库里拿到什么 落到哪个库、一块该多大 召回测试拿什么词验 合规性 规范条款原文 + 条号(第 4.0.1~4.0.4 条) 库① 规范库,一条一块 ——条号与条文不能分家 "资质证书 名称 编号" 创新性 往年项目编号、名称、创新点原文 库② 汇编库,一个项目一块 ——编号和创新点要在同一块里 "A-2024-01 创新点 LSTM" 成本收益 同类项目经费表的行(编号 / 总经费 / 设备占比 / 回收期)+ 统计口径 + 规范第 5 章门槛 库③ 台账库,整表一块 ——切开表格就不知道哪个数是哪一列;门槛在库① "同类项目 设备费占比 回收期"、"设备费 占比 上限" 必要性 / 可行性 / 设计依据 规范第 2、3、1 章条款;往年项目技术路线 库① + 库② "实施周期 18 个月"、"政策 文件名称 年份"
15 分怎么丢: 库里有这条但查不到(切错 / 阈值太高)→ 模型写"知识库未检索到";库里查到了但条号和条文不在一块 → 模型引对了内容编错了条号。两种都算"引用不准确"。所以本节的验收不是"建好了",而是13 个查询词都命中预期块 。
2 建库决策:为什么是三个库,不是一个比赛给的是一个团队知识库地址;本地 Dify 里我们建三个库。这不是偷懒,是三个硬理由。
先把三个词说人话: ① 知识库 = 一本书,我们有三本(规范、汇编、台账);② 一路知识检索 = 派一个人去查一个维度的资料,他可以同时翻几本书;六个维度就派六个人,所以叫六路;③ 审查节点 = 拿着查回来的资料写结论的人,七个维度七个人(第七个不查资料,只对照前六个找矛盾)。
① 三本书(知识库) ② 六个查资料的人(知识检索节点 R1~R6) ③ 七个写结论的人(大模型审查节点) 库① 审查规范库 01 规范 · 7 章 21 条 一条 = 一块(父块 = 章) 库② 创新点汇编库 02 汇编 · 7 个历史项目 一个项目 = 一块(父块 = 年份) 库③ 经费台账库 03 台账 · 表 + 口径 + 对标 整表一块 · 口径一块 · 对标一块 R1 查「必要性」依据 库① 库② R2 查「可行性」依据 库① 库② R3 查「创新性」依据 库② 库① R4 查「合规性」依据 库① R5 查「成本收益」依据 库③ 库① R6 查「设计依据与建设原则」依据 库① 库② 库③ ① 必要性审查 拿这一路查回来的依据写结论 ② 可行性审查 拿这一路查回来的依据写结论 ③ 创新性审查 拿这一路查回来的依据写结论 ④ 合规性审查 拿这一路查回来的依据写结论 ⑤ 成本收益审查 拿这一路查回来的依据写结论 ⑥ 设计依据审查 拿这一路查回来的依据写结论 ⑦ 语义一致性审查 不查库:只对照 ①~⑥ 的结论找矛盾 看图口诀: 一路 = 一个维度去查资料,一路可以同时翻几本书;库①是总规范,六路都要翻它。 图 2-1 三本书 → 六个查资料的人 → 七个写结论的人。线的颜色 = 翻的是哪本书 每路检索节点里,勾哪几个知识库(配节点时照着勾) R1 必要性 R2 可行性 R3 创新性 R4 合规性 R5 成本收益 R6 设计依据 库① 规范库 ✓ ✓ ✓ ✓ ✓ ✓ 库② 汇编库 ✓ ✓ ✓ — — ✓ 库③ 台账库 — — — — ✓ ✓ 竖着看:R4 合规只勾库①;R6 设计依据三个都勾。横着看:库① 六路全勾——它是审查的总依据。 图 2-2 配每一路检索节点时,照这张勾选表勾库 理由 说明 分段策略必须不同 规范要按"条"切、汇编要按"项目"切、台账要整表不切。一个库里混三种分段模式,只能逐文档改分段,改漏一份就查不准。 检索路由更准 查创新点时只连汇编库,就不会把经费台账里同样带"经费"字样的行捞进来;查经费时只连台账库 + 规范第 5 章,噪声少一半。 三人可以并行 一人守一个库:建库、调分段、做召回测试互不等待;最后把三个库挂到六路检索上即合流。
知识库 放什么 一块 = 什么 下午哪几路检索会勾它 回答哪类问题 库① 审查规范库 01 规范(7 章 21 条) 一条 = 一块;父块 = 章 R1 R2 R3 R4 R5 R6(全部) 必要性 / 可行性 / 合规性 / 创新性 / 成本收益 / 设计依据 库② 创新点汇编库 02 汇编(7 个项目) 一个项目 = 一块;父块 = 年份 R1 R2 R3 R6 创新性(主)、可行性与设计依据(技术现状佐证) 库③ 经费台账库 03 台账(表 + 口径 + 对标) 整表一块、口径一块、对标一块 R5 R6 成本收益(主)、设计依据(相似项目对标)
命名约定(三人统一): kb-guifan-姓名缩写、kb-chuangxin-姓名缩写、kb-taizhang-姓名缩写。库名写进团队约定表,下午实操四六路检索节点勾库时照表勾。
3 库① 审查规范库:逐项参数 + 召回测试库① 规范:空行分章 → 父块,换行分条 → 子块 入库版 .md 文档长这样 ## 第五章 经济性要求 ### 第5.0.1条 经费预算应分列设备费、材料费… ### 第5.0.2条 设备费占总预算比例一般不低于 50%… ### 第5.0.3条 静态投资回收期一般不超过 5 年… ## 第六章 创新性要求 … 父分段标识符 \n\n 父分段最大长度 2000 子分段标识符 \n 子分段最大长度 500 替换连续空格换行 取消勾选 父块 第五章 经济性要求 子块 第5.0.1条 经费预算应分列设备费、材料费、人工费、其他费用四类… 子块 第5.0.2条 设备费占总预算比例一般不低于 50%;其他费用不高于 10% ← 命中 子块 第5.0.3条 静态投资回收期一般不超过 5 年… 查“设备费占比上限”命中子块 5.0.2 → 模型同时拿到 子块(这一条)+ 父块(整章),既精准又有上下文。 图 3-0 分段四个参数各管什么:先看懂这张图,再往下一步步点 2000 和 500 是怎么来的: 先定单位——子块 = 检索单位 = 一条,父块 = 阅读单位 = 一章。再数字数:本规范每条正文 50~150 字、每章 150~200 字(含模板表的最长一章约 2000 字)。子块最大长度 500 = 条的上限加余量,保证一条一定装得下、又不会两条挤一块;父块最大长度 2000 = 章的上限,保证最长章不被切断。有空行 / 换行分隔符时实际按分隔符切,最大长度只是“分隔符缺失或单段过长”时的上限保护。最后用预览块验证:第5.0.2条独立成块、父块整好是第五章,就对了;条被切成两块调大子块,两条挤一块调小子块。库② 一个项目约 120 字 → 子块 800;库③ 整表不能切 → 子块 2000;父子模式没有重叠参数:子块命中时平台自动把它所在的父块一并返回,上下文由父块保证,不靠重叠。
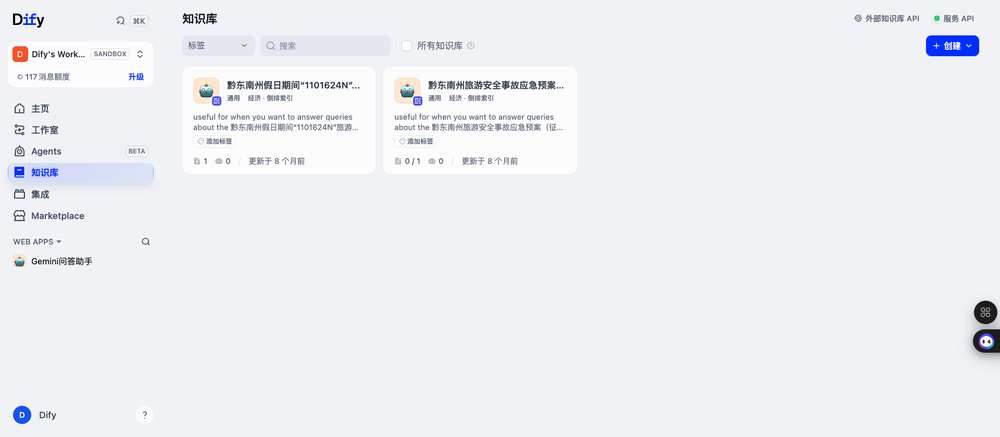
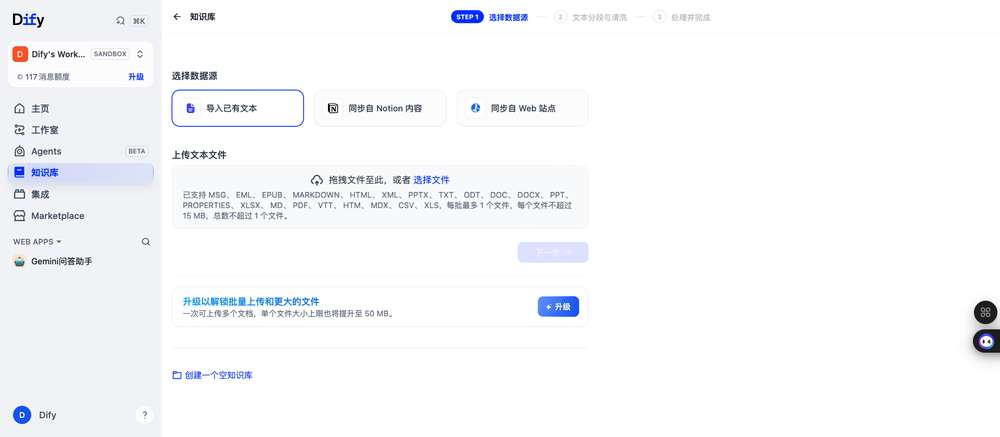
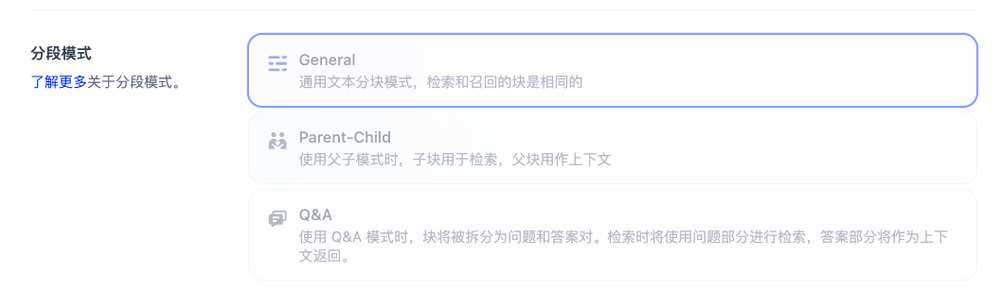
真实平台 · 知识库列表:卡片上标着分段模式与索引方式,建库前先确认自己库里是哪一种。 真实平台 · 创建第①步:选「导入已有文本」→ 上传区拖文件 → 「下一步」进分段设置。下面步骤里的按钮名与此界面一致。 真实平台 · 分段模式三种:General / Parent-Child / Q&A。分隔符、长度、重叠是前两种模式里的参数,不是第四种模式。
本地 Dify 顶部导航 知识库 → 右上 创建知识库 → 选 导入已有文本 。
拖入 素材/知识库文档/01_审查规范_入库版.md(只传这一个文件)→ 命名 kb-guifan-姓名缩写 → 下一步 。
分段模式选 Parent-Child(父子分段) ——平台共三种:General(通用,检索和召回同一批块)/ Parent-Child(子块检索、父块作上下文)/ Q&A(拆问答对,问题检索、答案作上下文),真实界面见本节第三张图;本文档有「章 / 条」两级层级,所以选父子。
父分段标识符填 \n\n(段落空行),父分段最大长度 2000 。
子分段标识符填 \n(换行 = 一条一行),子分段最大长度 500 。父子模式没有重叠输入框;"替换掉连续的空格、换行符和制表符"这一项取消勾选 (勾上会把空行吃掉,父块就切不开)。
文本预处理:两项都不勾 。"替换掉连续的空格、换行符和制表符"会把空行吃掉、父块切不开;"删除 URL 和邮箱"没必要。
点右侧预览块 :翻到第五章,确认「第5.0.2条」是独立一块、且它的父块是「第五章 经济性要求」。
为什么这么填(3.1 逐条): ① 选「导入已有文本」而不是同步 Notion / 网站——教学文档在本地,同步通道既慢又可能把文件传到外部;② 只传一个文件——分段设置按"这一批"生效,三份文档分段策略不同,一起传只有一份能切对;③ 选 Parent-Child——规范有「章 / 条」两级编号,父块保上下文、子块保命中精度;文档完全没有层级才退回 General;资料本身是问答 / FAQ 形态就选 Q&A(问题用于检索、答案作上下文,不用填分隔符);④ 父标识符 \n\n(空行)、子 \n(换行)——平台入库时会先去掉 # 号,所以不能填 ##/###;入库版 md 章与章之间空行、条与条之间换行,用这两个符号切比按字数切干净;⑤ 父 2000 / 子 500——子块≈一条完整条款的字数×1.5,父块≈一章;⑥ 父子模式没有重叠这一项——子块命中后自动带父块做上下文,不需要重叠;⑦ 取消勾选 「替换连续空格换行」——勾上会把空行吃掉,父块就切不开;也不勾「删除 URL 和邮箱」;⑧ 必看预览块——切得对不对不用猜,抽三处看一眼就知道。
dify.local / 知识库 / 创建 / 分段设置 界面示意图
分段设置 · kb-guifan
子分段标识符 / 最大长度(父子模式无重叠项)
\n | 500
预览块 刷新
父块 第五章 经济性要求
↳ 子块 第5.0.1条 经费预算应分列设备费、材料费、人工费、其他费用四类,各类费用占比应说明依据。
↳ 子块 第5.0.2条 设备费占总预算比例一般不低于 50%,低于 50% 的应说明原因;其他费用占比一般不高于 10%。
↳ 子块 第5.0.3条 经济效益测算应给出年节约金额或年增收金额及计算过程,静态投资回收期一般不超过 5 年。
图 3-1 父子分段:父 = 空行分出的段落,子 = 换行分出的条;右侧预览确认每条独立成块(全文短于 2000 字时所有子块都标 C-1,正常) 库① 索引与检索设置:六个旋钮,照图拧 索引方式 高质量 经济 为什么 要“按意思找”就必须高质量;经济模式不建向量,按意思找直接失 效 检索模式 向量检索 全文检索 混合检索 为什么 条款号 / 项目编号靠全文(字面),口语表述靠向量(意思)— —两个都要,所以混合 权重 语义(按意思) 0.5 关键词(按字面) 0.5 为什么 条款号查不准 → 关键词往右拉到 0.6;换个说法查不到 → 语义往左拉到 0.6 Rerank 重排 权重设置 为什么 选「权重设置」而不是「Rerank 模型」——云端 / 本地多半没接重排模型; Top K 调小 Top K 召回条数 10 1 20 为什么 一次返回几条。漏依据 → 15;无关段太多 → 6~8 Score 阈值 关 为什么 起手先关:实测正确命中分只有 0.13~0.44,开 0.3 会把大半依据拦掉;引了不相干内容再抬 → 0.5 起手值照抄即可。真正经常动的只有三个:权重、Top K、Score 阈值;一次只动一个,动完做一遍召回测试。 图 3-2 库① 的六个设置项与起手值;右列是为什么这样填
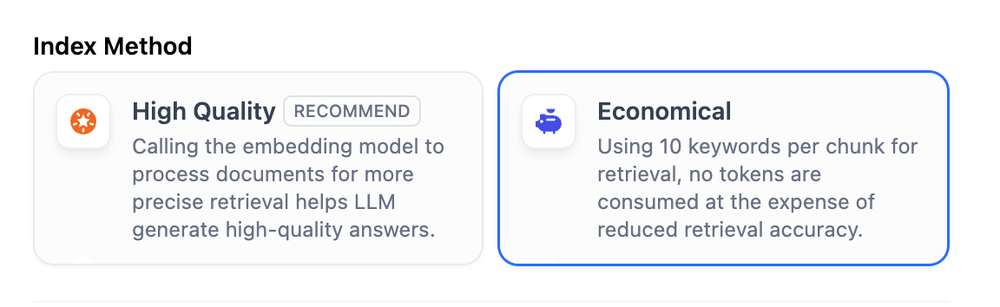
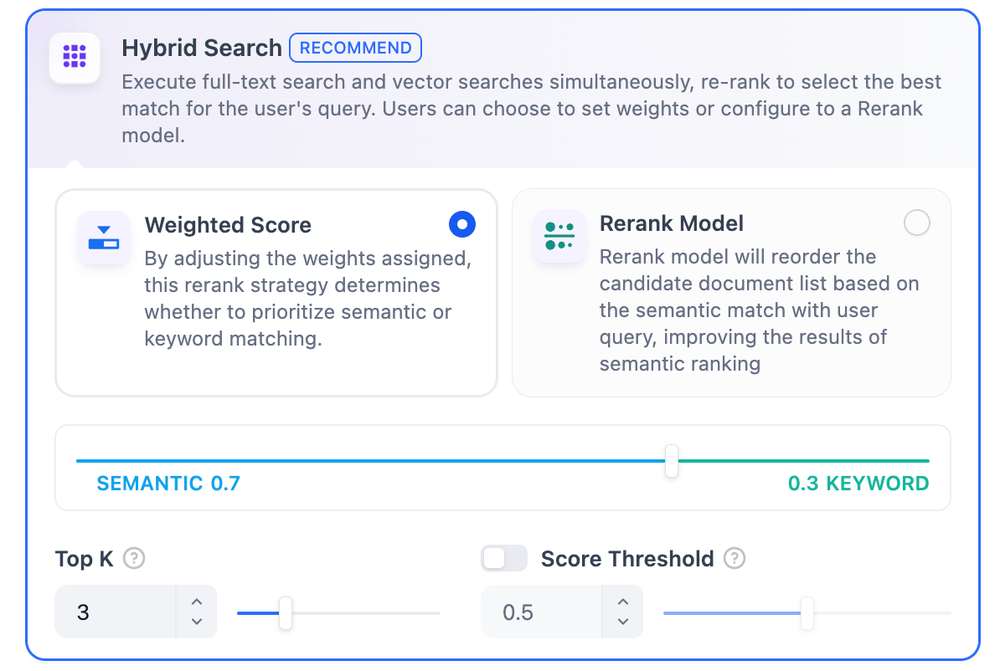
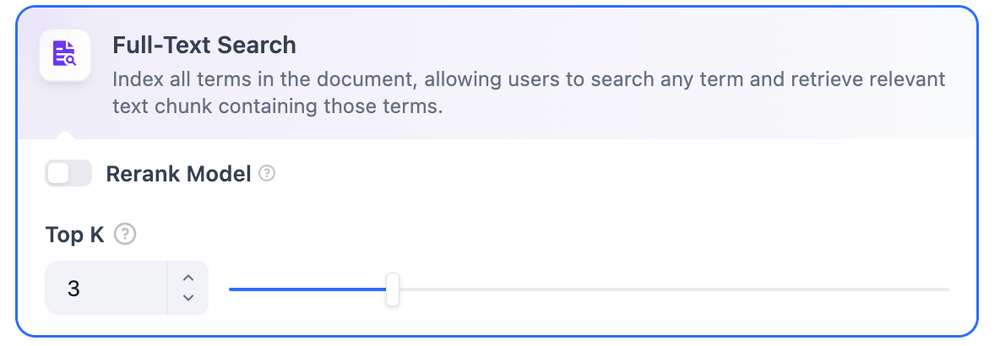
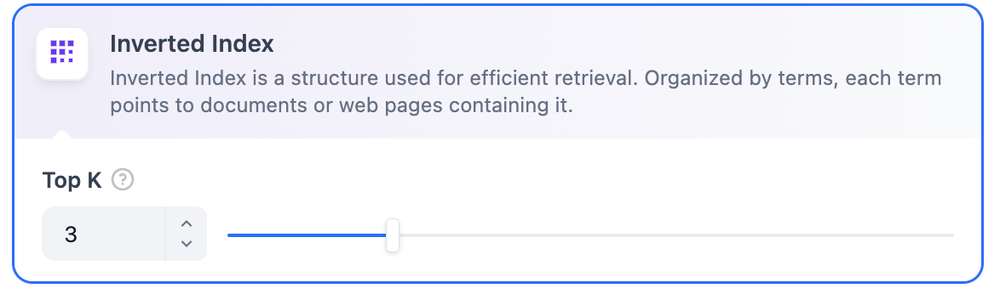
真实界面(Dify 官方文档截图)· 索引方式:高质量(RECOMMEND,建向量索引)/ 经济(每段 10 个关键词、倒排索引);下方即检索设置三模式:向量检索 / 全文检索 / 混合检索(RECOMMEND)。 真实界面 · 混合检索展开:重排策略二选一(Weighted Score 权重滑杆 / Rerank 模型);滑杆即语义 0.7 : 关键词 0.3;下面两个旋钮=Top K 与 Score Threshold(可关)。 真实界面 · 全文检索展开:只有 Rerank 开关与 Top K(没有权重滑杆)——纯关键词场景用它。 真实界面 · 经济型索引的检索面板:倒排索引 + Top K,没有语义路 ——所以经济库开不了向量/混合检索,建库前就要想清楚。
设置项 填什么 为什么 索引方式 高质量 要语义匹配("花钱的比例"要能查到"费用占比");经济模式不建向量索引,语义检索直接失效 Embedding 模型 三个库选同一个(课堂环境列表里有的那一个) 三库必须一致;实测库① 单独用了另一个模型时召回永远为空,改成与库②③ 一致后才命中 检索模式 混合检索 "第5.0.2条"这种条号靠关键词精确命中;表述类问题靠语义 权重 语义 0.5 / 关键词 0.5 样题参考答案的 RAG 节点即 BM25 权重 0.5 / 向量权重 0.5 Rerank 模型 权重设置(不选 Rerank 模型) 混合检索的重排二选一:没接重排模型就选「权重设置」,用滑杆配比;选了 Rerank 模型但环境没有,检索会直接报错 Top K 10 一个维度一次检索,10 条足够覆盖;太小会漏依据 Score 阈值 关(起手) 检索时库里每一块都和查询词比一次,打一个 0~1 的相关度分,越像分越高,完全不相干接近 0。阈值是及格线:低于线的块,即使排进 Top K 也不要。它和 Top K 是两层筛:Top K 管“最多留几条”,阈值管“再差也不能差过多少”。起手先关:实测本课三个库用 Qwen3-Embedding + 加权混合检索,正确命中的分只有 0.13~0.44,开 0.3 会把"设备 ≥ 50%""回收期 ≤ 5 年"这类依据拦在外面。召回稳定后若引了不相干内容,再从 0.1 往上抬
点 保存并处理 ,等状态变「可用」(约半分钟)再做召回测试。
知识库页右上「召回测试」。查不到的东西,工作流里也查不到 ——这一步不做,后面全是盲调。
测试查询词 应命中(Top 3 内) 没命中先动哪里 设备费 占比 上限 其他费用 比例 第5.0.2 条 子分隔符是不是 \n;预览块里 5.0.2 是否独立成块 实施周期 18 个月 超过 分阶段 阶段目标 第3.0.3 条 同上 资质证书 名称 编号 合作单位 保障条件 第4.0.3 / 4.0.4 条 Top K 调到 15;关键词权重调到 0.6 创新点 与 已立项项目 重复 认定 第6.0.2 条 语义权重调到 0.6 政策 引用 文件名称 发文年份 第2.0.1 条 —
记录表(必做): 每个查询词记一行「查询词 / Top 3 命中块 / 是否满足 / 调了什么」。这张表下午实操四直接复用。
现象 先动哪里 怎么调 / 为什么 召回测试搜得到、工作流搜不到 查询词 查询词只留本维度技术词 + 项目名;别把六个维度的词混进一路 查条款号回来相邻别的条 检索模式 / 权重 改混合检索,关键词权重调到 0.6;语义路会把 3.0.1/3.0.2/3.0.4 一起捞回来 依据漏了(回答里该引的没引) Top K 10 → 15;先多召回,噪声交给提示词筛 无关段太多、回答被带偏 Top K / Score 阈值 Top K 6~8,或开 Score 阈值从 0.1 起试;一次只动一个 引用条号对、内容对不上 分段 条号与条文被切开:改子分段标识符后重新入库 ,不是刷新页面 回答没有任何引用 Score 阈值 / 索引方式 阈值先关;再查索引是不是经济型(经济型没有语义路) 一直"索引中" Embedding 模型 向量模型没接上;接上前调任何检索参数都白费
调参纪律: 一次只动一个参数,动完跑一遍召回测试再动下一个;同时改两个,命中变好也不知道是谁的功劳。
4 库② 创新点汇编库:逐项参数 + 召回测试库② 汇编:空行分段 → 父块 2000,子块也按空行 800(标题与正文各一块) 入库版 .md 文档长这样 ## 2024 年 ### 项目 A-2024-01 压气机状态监测 创新点一:LSTM 效率预测… 创新点二:残差法漂移自诊断… 立项经费 410 万元 ### 项目 A-2024-04 电厂级 AI 知识库 创新点:规程规范统一入库… ## 2023 年 … 父分段标识符 \n\n 父分段最大长度 2000 子分段标识符 \n 子分段最大长度 800 替换连续空格换行 取消勾选 父块 2024 年 子块 A-2024-01 压气机状态监测与效率预测 创新点一 + 创新点二 + 经费,整项目在同一块 ← 命中 子块 A-2024-04 电厂级 AI 知识库与智能问答 创新点 + 经费 子块 A-2024-0x … … 子块 800:一个项目约 120 字,不会被二次切断。标题与正文间有空行 → 各成一块(预览 19 块),两块都能命中。 图 4-0 库② 分段:与库① 唯一不同是子标识符用 \n\n、长度 800
新建知识库 → 导入 02_创新点汇编_入库版.md → 命名 kb-chuangxin-姓名缩写。
分段模式 父子分段 ;父标识符 \n\n,最大长度 2000 。
子标识符 \n\n(段落),最大长度 800 。一个项目含编号、名称、创新点、经费约 120 字,800 保证整项目不被二次切断。实测提醒: 入库版 .md 里项目标题和正文之间有空行,所以"项目 A-2022-03 ……"标题和"创新点一:……"正文会各成一块(预览 19 块);要让一个项目成一块,入库前把标题与正文之间的空行删掉即可,不改也能检索到。
预处理同库①(两项不勾)。预览块确认:共 19 块,"项目 A-2024-01 …"一块、它的"创新点一 / 创新点二 / 立项经费"紧跟一块;召回时两块都会命中。
✔ 分对了 【父块】2024 年
【块】项目 A-2024-01 压气机状态监测与效率预测
创新点一:基于 LSTM 的压气机效率单步预测模型。创新点二:多测点冗余残差法的传感器漂移自诊断。立项经费 410 万元。
为什么好: 命中这一块,"重复的是哪个项目、重复了哪条创新点"一次全拿到,引用时直接写 A-2024-01。
✘ 分错了 【块】…传感器漂移自诊断。立项经费 410 万元。
项目 A-2024-04 电厂级 AI 知识库与智能问答
创新点:规程、规范、历史检修记录统一入库…
为什么不好: 子块长度设太小,一个项目被切成两块、或两个项目挤进一块;比对重复时张冠李戴。
库② 索引与检索设置:与库① 完全相同 索引方式 高质量 经济 为什么 要“按意思找”就必须高质量;经济模式不建向量,按意思找直接失 效 检索模式 向量检索 全文检索 混合检索 为什么 条款号 / 项目编号靠全文(字面),口语表述靠向量(意思)— —两个都要,所以混合 权重 语义(按意思) 0.5 关键词(按字面) 0.5 为什么 条款号查不准 → 关键词往右拉到 0.6;换个说法查不到 → 语义往左拉到 0.6 Rerank 重排 权重设置 为什么 选「权重设置」而不是「Rerank 模型」——云端 / 本地多半没接重排模型; Top K 调小 Top K 召回条数 10 1 20 为什么 一次返回几条。漏依据 → 15;无关段太多 → 6~8 Score 阈值 关 为什么 起手先关:实测正确命中分只有 0.13~0.44,开 0.3 会把大半依据拦掉;引了不相干内容再抬 → 0.5 起手值照抄即可。真正经常动的只有三个:权重、Top K、Score 阈值;一次只动一个,动完做一遍召回测试。 图 4-2 库② 六个旋钮,全部照库① 抄 设置项 填什么 为什么 索引方式 高质量 同库① 检索模式 混合检索 技术词(LSTM、残差、漂移)靠语义;项目编号 A-2024-01 靠关键词 权重 语义 0.5 / 关键词 0.5 同库① Rerank / Top K / Score 权重设置 / 10 / 关 同库①
测试查询词 应命中(Top 3 内) 没命中先动哪里 LSTM 压气机 效率 单步预测 模型 A-2024-01 块 子块是否整项目一块;长度放到 800 多测点 冗余 残差 传感器 漂移 自诊断 A-2024-01 块 同上 燃烧 配风 闭环 强化学习 二次风门 A-2022-03 块 语义权重调到 0.6 知识图谱 故障原因 推理 检修建议 A-2023-02 块 — A-2023-05 脱硝 喷氨 创新点 A-2023-05 块 关键词权重调到 0.6(编号类查询)
5 库③ 经费台账库:逐项参数 + 召回测试库③ 经费台账:按空行切成三块,表格 7 行之间没有空行、整表一块 03_经费台账_入库版.md ## 历史同类项目经费台账 | 编号 | 项目 | 总经费 | 设备费 | … | | A-2022-03 | 燃烧配风… | 520 | 61% | | A-2023-02 | 知识图谱… | 380 | 55% | | …(共 7 行) ## 统计口径 平均总经费 / 设备费占比 / 回收期 … ## 对标提示 总经费超均值 30% 需说明 … 父 \n\n · 2000 子 \n\n · 2000 表格行间没有空行 → 整表不切 块 1 台账表(表头 + 7 行,完整) 列名 ↔ 数值 的对应关系保住了 块 2 统计口径 平均值、占比口径 块 3 对标提示 偏差超过多少要说明 切开表格 = 丢掉“哪一列是哪个数”。所以子分段长度给到 2000,让它根本切不动。 图 5-0 库③ 分段:三块,表格不切
新建知识库 → 导入 03_经费台账_入库版.md → 命名 kb-taizhang-姓名缩写。
分段模式 父子分段 ;父标识符 \n\n,最大长度 2000 ;子标识符 \n\n,最大长度 2000 。表格 7 行之间没有空行,整表成一块(实测预览 Chunk-4 = 360 字整表)——7 行表格不会被拦腰截断 。务必取消"替换掉连续的空格、换行符和制表符",否则表格行会被压成一行。
预览块确认共 3 块:台账表(含表头与 7 行)、统计口径、对标提示。
表格为什么不能切: 切开就丢了"列名 ↔ 数值"的对应关系,模型会把 A-2022-03 的人工费读成 A-2023-02 的。整表一块 + 2000 长度是保表格的最低成本做法。
库③ 索引与检索设置:只有权重不一样 索引方式 高质量 经济 为什么 要“按意思找”就必须高质量;经济模式不建向量,按意思找直接失 效 检索模式 向量检索 全文检索 混合检索 为什么 条款号 / 项目编号靠全文(字面),口语表述靠向量(意思)— —两个都要,所以混合 权重 语义(按意思) 0.4 关键词(按字面) 0.6 为什么 条款号查不准 → 关键词往右拉到 0.6;换个说法查不到 → 语义往左拉到 0.6 Rerank 重排 权重设置 为什么 选「权重设置」而不是「Rerank 模型」——云端 / 本地多半没接重排模型; Top K 调小 Top K 召回条数 10 1 20 为什么 一次返回几条。漏依据 → 15;无关段太多 → 6~8 Score 阈值 关 为什么 起手先关:实测正确命中分只有 0.13~0.44,开 0.3 会把大半依据拦掉;引了不相干内容再抬 → 0.5 红底行 = 这个库与库①不同的地方;其余照抄。所有值都是起手值,调之前先做召回测试。 图 5-2 库③ 六个旋钮:关键词权重拉到 0.6(查编号、费用名这类死字符串多) 设置项 填什么 为什么 索引方式 高质量 同库① 检索模式 混合检索 同库① 权重 语义 0.4 / 关键词 0.6 本库大量查询是项目编号、费用类别这类死字符串,关键词权重调高一点命中更稳 Rerank / Top K / Score 权重设置 / 10 / 关 同库①
测试查询词 应命中(Top 3 内) 没命中先动哪里 同类项目 平均 总经费 设备费占比 人工费占比 回收期 统计口径块 语义权重回到 0.5 总经费 超过 均值 30% 人工费 40% 其他 10% 说明依据 对标提示块 Top K 调到 15 A-2023-05 脱硝 总经费 人工费 回收期 台账表块(含该行) 关键词权重调到 0.7 设备费 材料费 人工费 其他费用 构成 台账表块 + 统计口径块 —
6 课堂分工与 55 分钟节奏表(只建库、只测召回)三人一组,一人守一个库。库名先抄进团队约定表再动手。
时间 A(库① 审查规范) B(库② 创新点汇编) C(库③ 经费台账) 0-10 分 上传 01 .md → 父子分段 \n\n/2000 + \n/500 → 预览核对一条一块 → 高质量索引 → 混合检索 0.5/0.5 上传 02 .md → 父子分段 \n\n/2000 + \n\n/800 → 预览 19 块 → 同库① 检索设置 上传 03 .md → 父子分段 \n\n/2000 + \n\n/2000 → 预览里整表一块 → 权重 0.4/0.6 10-20 分 等索引完成;状态变「可用」 同 同 20-40 分 第 3.3 节 5 个查询词逐个召回,填记录表 第 4.3 节 4 个查询词 第 5.3 节 4 个查询词 40-50 分 没命中的按第 3.4 节速查表调:先看预览分段 → 再看权重 → 再看阈值;调完重新处理文档 再测 50-55 分 三人把库名、文档名、分段参数、13 条召回结果抄进团队约定表;拍一张三库「可用」截图
交付物清单: 三个「可用」知识库 + 召回测试记录表(13 行) + 团队约定表。下午实操四的六路检索节点只需勾库,不再碰分段。
7 常见问题 / 自检 / 保密 / 下午怎么用这三个库现象 多半原因 处理 召回测试查"5.0.2"查不到 子分隔符没生效,整章一块 子标识符改成 \n(不要填 ###,平台会先去掉 # 号);预览里一条一块才对;重新分段 召回测试查创新点命中的是别的库 在"所有知识库"页面测的,混了三个库 进到库②自己的页面做召回测试;每个库单独测 台账表格被切成两半 子分段最大长度太小,或勾了"替换连续空格换行" 库③子长度改 2000;取消勾选"替换掉连续的空格、换行符和制表符" 知识库一直"索引中" Embedding 模型没接上 找讲师 / 管理员确认模型配置
团队约定表填完:三个库名、各库分段参数、13 条召回结果
三个库的 Embedding 模型一致(都选同一个,混用会出现某个库永远查不到)
保密口径: 本节所有文档为虚构教学版。不把真实规程、真实项目可研、真实经费数据上传到任何外部 Dify / 云服务;本地 Dify 的知识库按团队权限建,不混用、不共享给其他组。
下午怎么用这三个库: 实操四搭完整工作流(文档提取 → 摘要抽取 → 校验 / 分支 / 指标计算 → 六路知识检索 → 七个审查 → 概要 → JSON → HTML → 结束)。六路知识检索节点各勾今天的一到三个库——哪一路勾哪几个,看第 2 节图 2-2;查询词、提示词、代码全部在实操四手册里,今天不用管。
中软国际 · 华电新疆公司集团 AI 竞赛赛前培训 · Day4 · 实操三 知识库搭建与 RAG 研判(完全还原版)