华电新疆公司 · 集团 AI 竞赛赛前培训 · 第二天 · 模型调优
模型调优(二)· 超参数、曲线诊断与判读练习
下午课配套材料:逐个解释平台上要填的每个超参数,再讲训练曲线的健康形态与四种典型问题,给出对症调参表,最后 8 题判读练习。
下午课配套材料:逐个解释平台上要填的每个超参数,再讲训练曲线的健康形态与四种典型问题,给出对症调参表,最后 8 题判读练习。
平台上要填的就这几个,每个都用一张图说清楚。
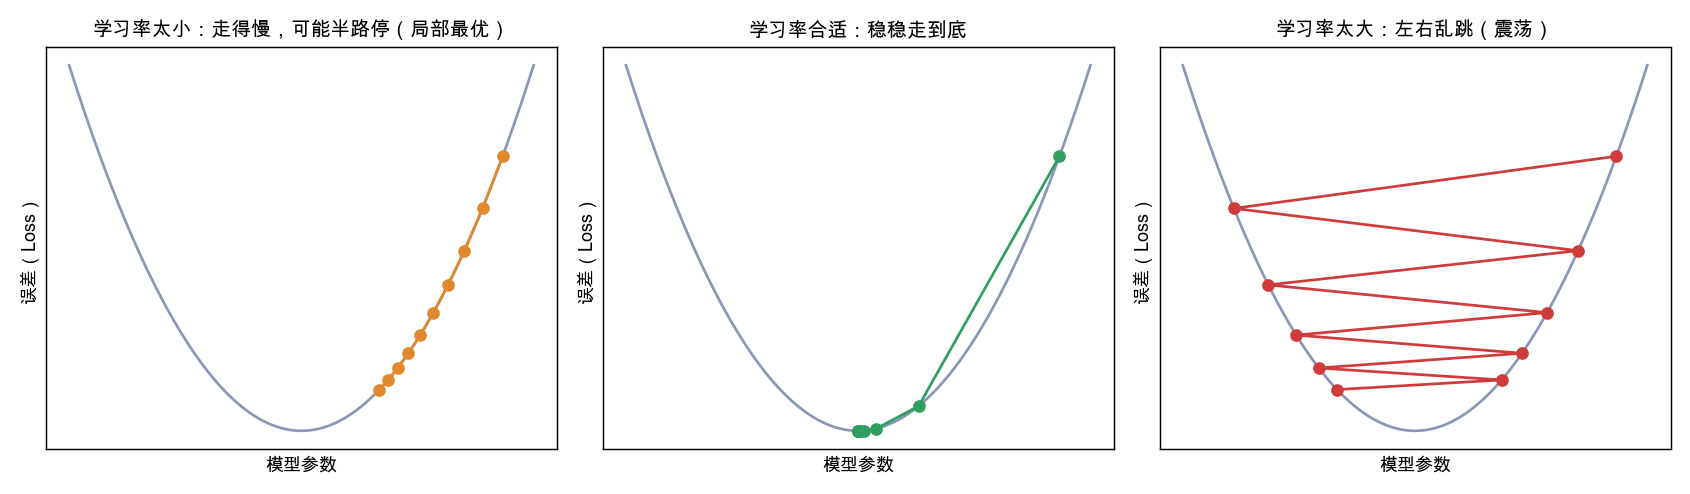
模型每次「改错」改多大一步。太大→ 跳过头、来回抖(震荡);太小→ 走得慢、可能半路停住(局部最优)。平台范围 0.00001–0.1,第一次填 0.001(LSTM/GRU/RNN/DNN)或 0.05(XGBoost)。
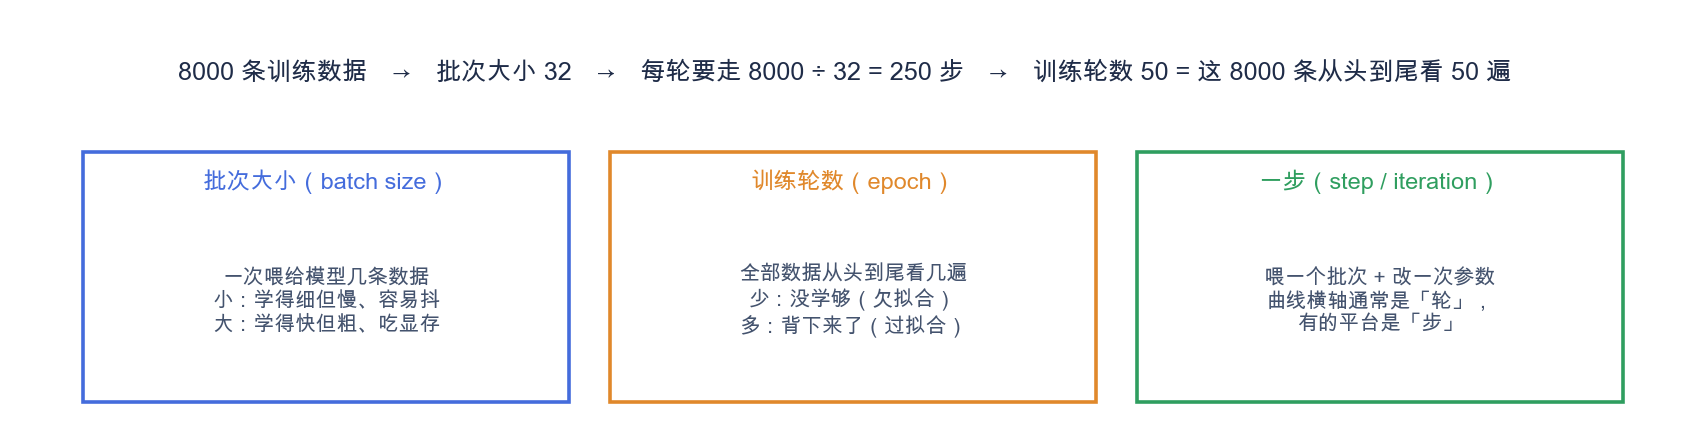
一次喂几条数据给模型。小→ 学得细但慢、曲线容易抖;大→ 快但粗。第一次填 32。只有神经网络(DNN/RNN/LSTM/GRU)有这个参数。
全部训练数据从头到尾看几遍。少→ 没学够(欠拟合);多→ 背下来了(过拟合)。平台 10–500,第一次填 50,看曲线再加减。
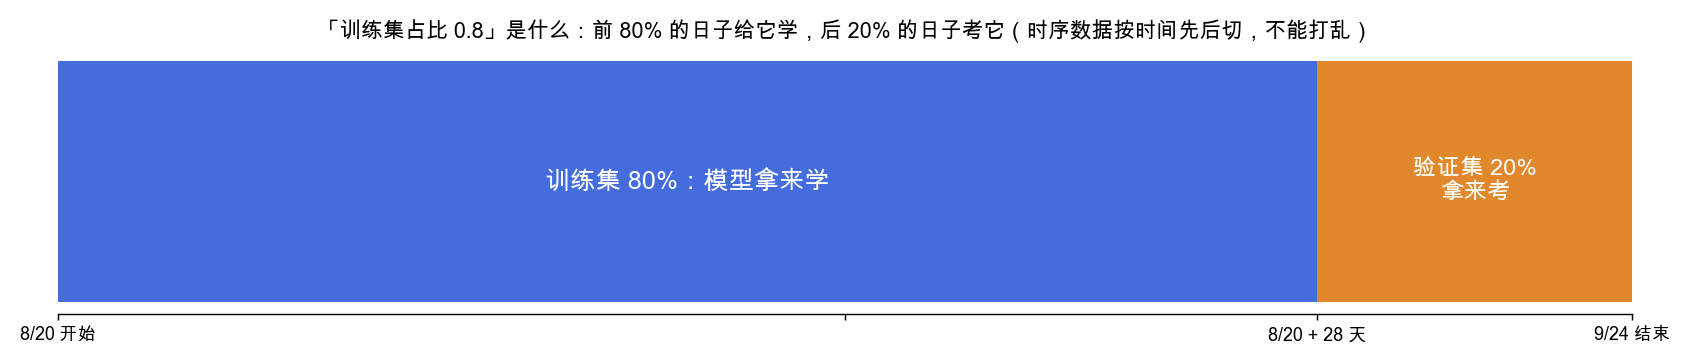
把数据切两份:前面一份给模型学(训练集),后面一份考它(验证集)。0.8 = 前 80% 学、后 20% 考。时序数据按时间先后切,不打乱。范围 0.5–0.95,填 0.8 就行。
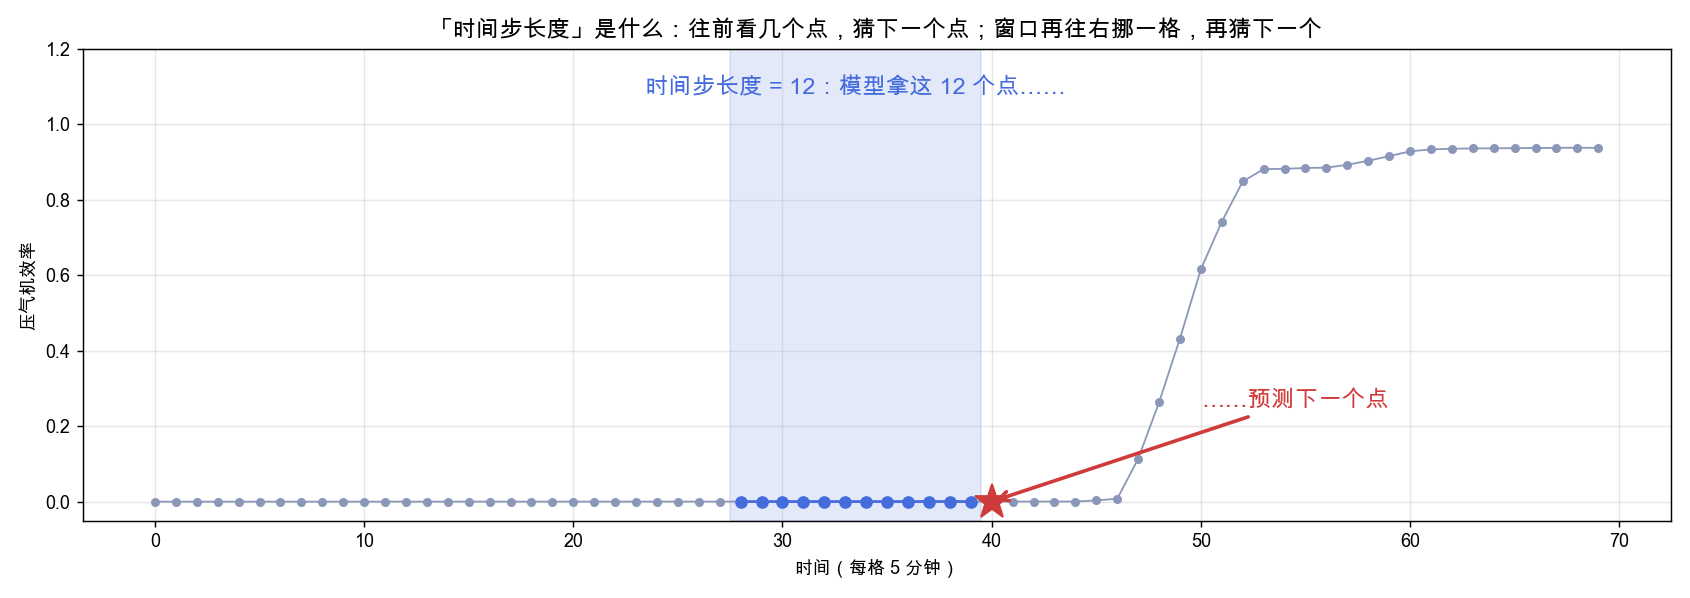
往前看几个点来猜下一个点。这题最关键的参数,上午课第 5 节已讲。平台范围 5–100。
模型「有多大脑容量」。层多、神经元多 → 能学复杂规律,但慢、容易过拟合。第一次 2 层 × 64;过拟合就减、欠拟合就加。
XGBoost 是很多棵「判断树」投票。树多、树深 → 更准但更慢、易过拟合。第一次 200 棵 × 深 6。
题目里提到,但平台界面没有这个选项,不用管。
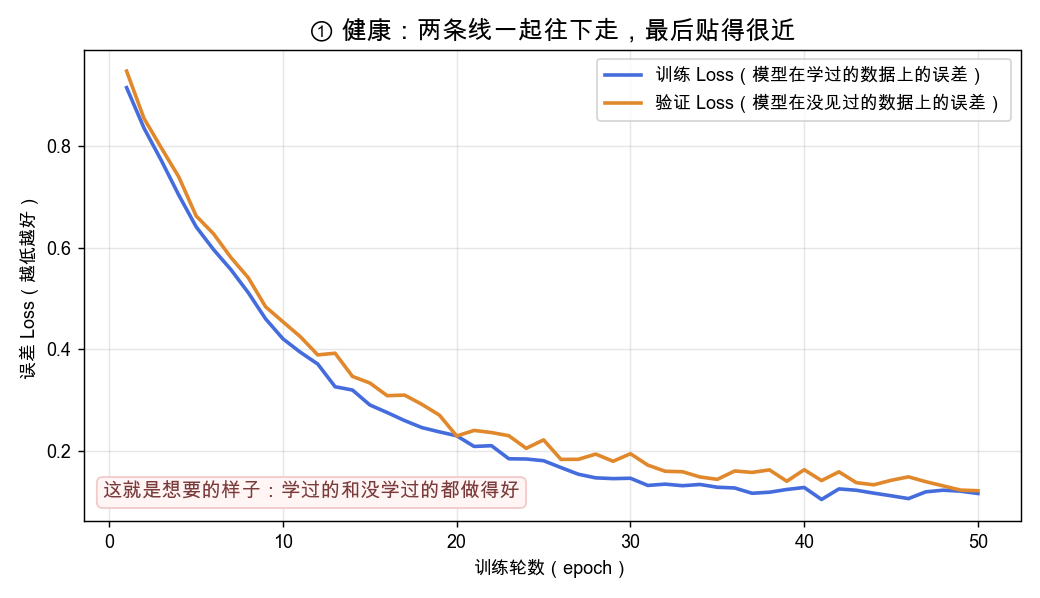
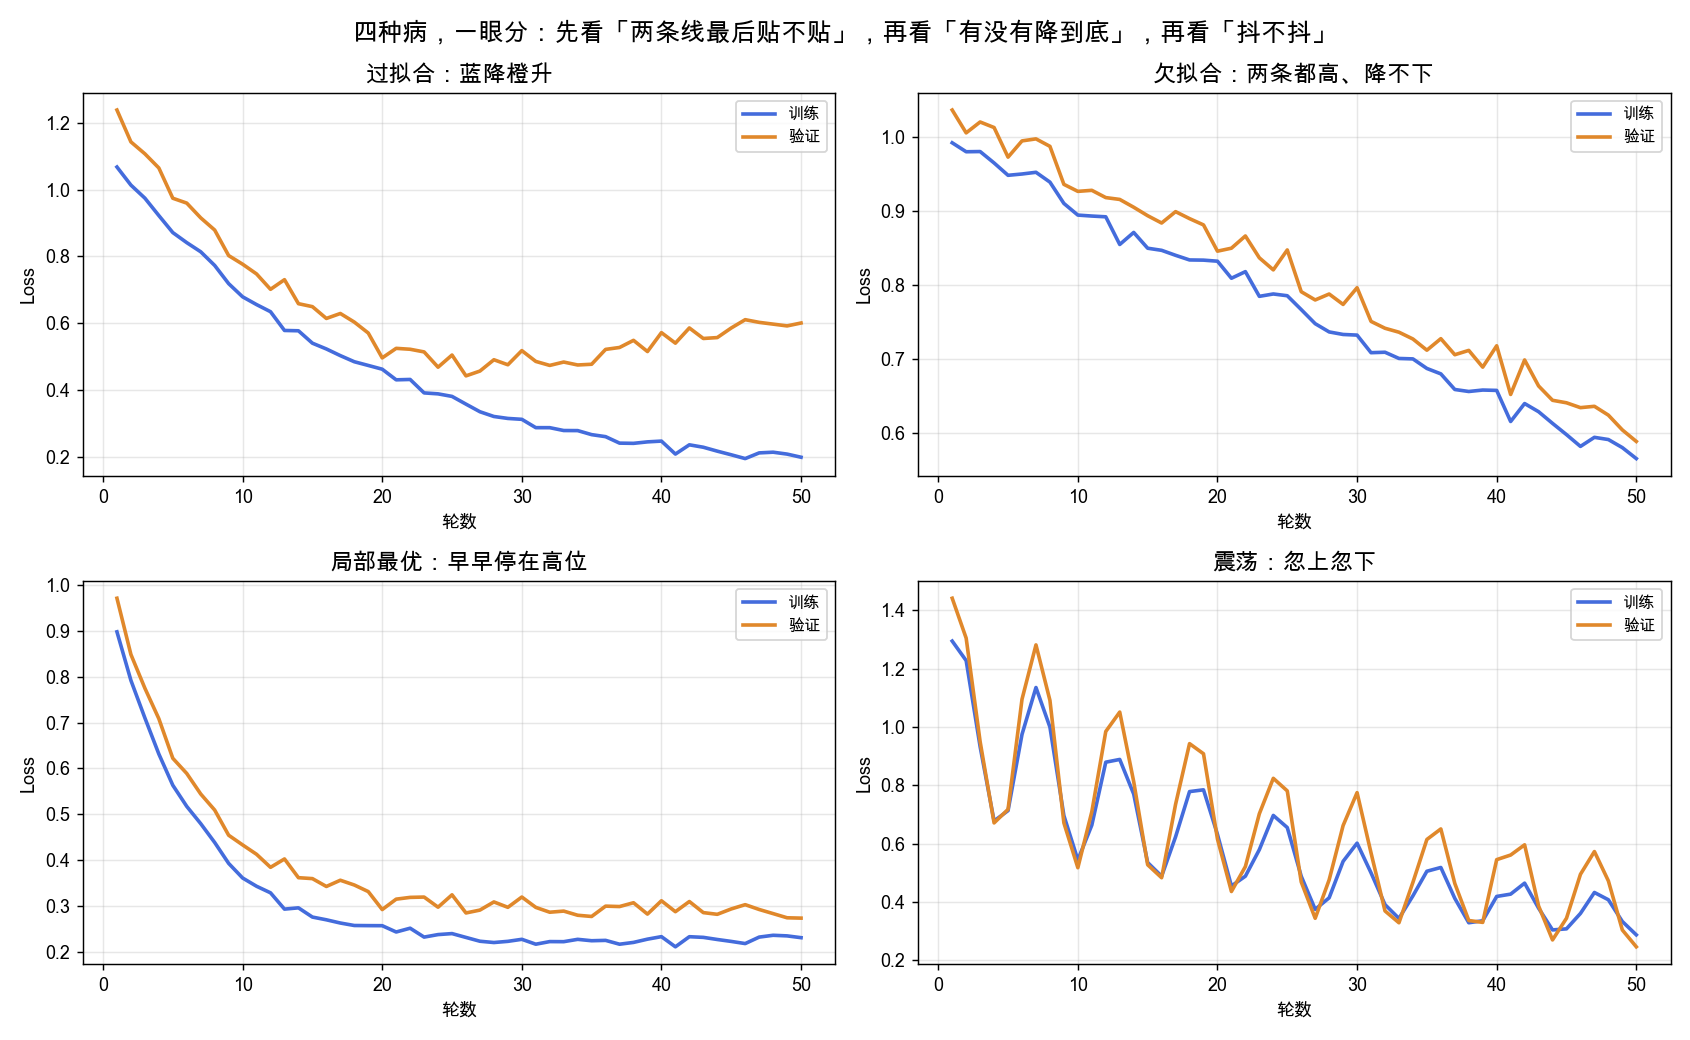
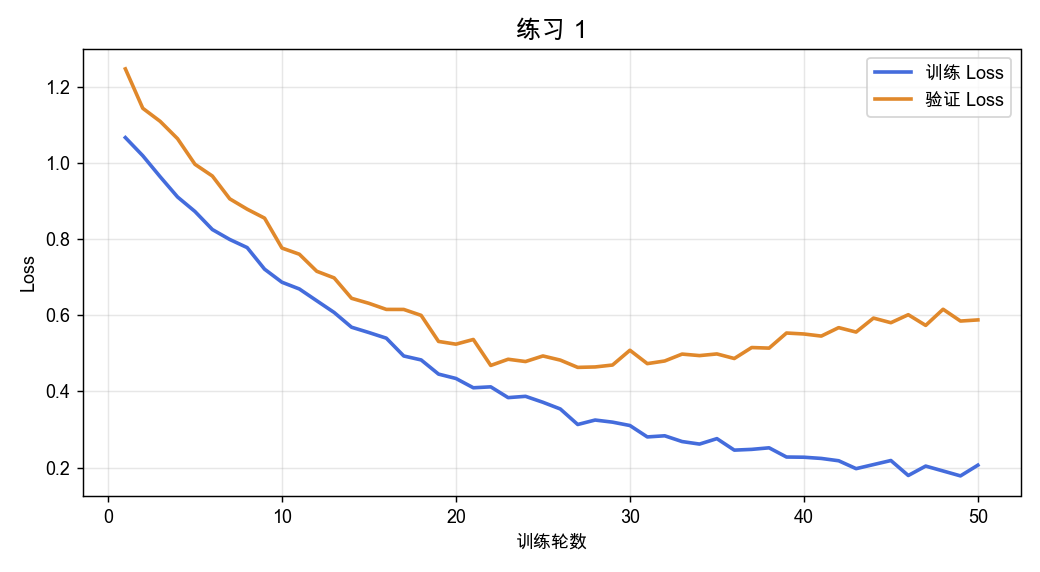
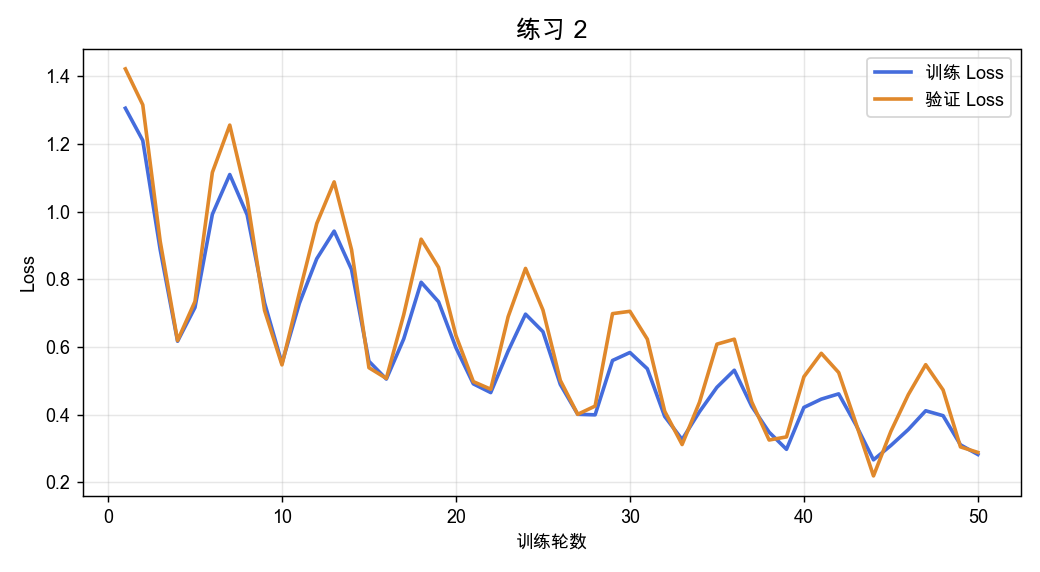
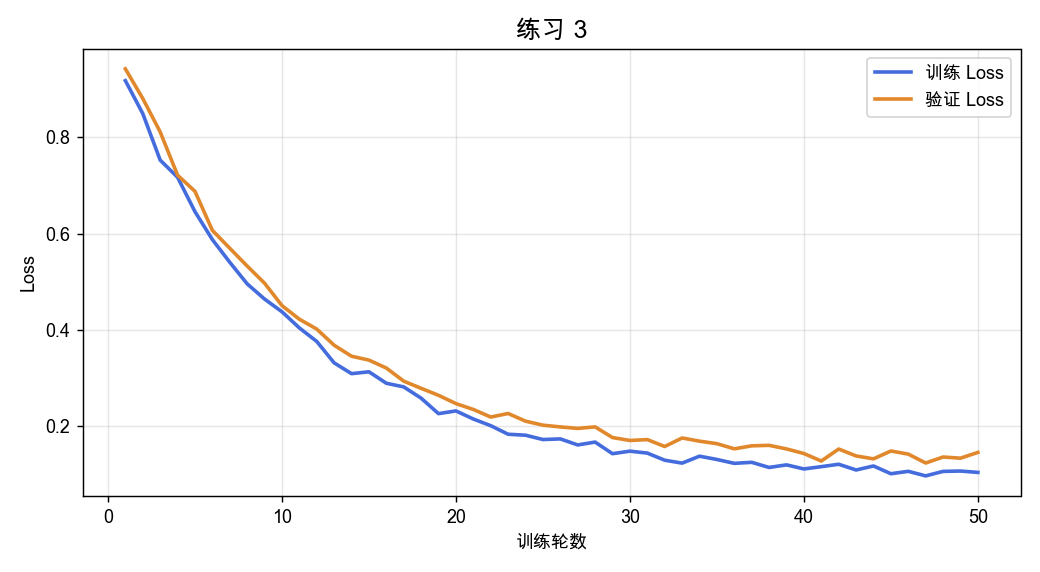
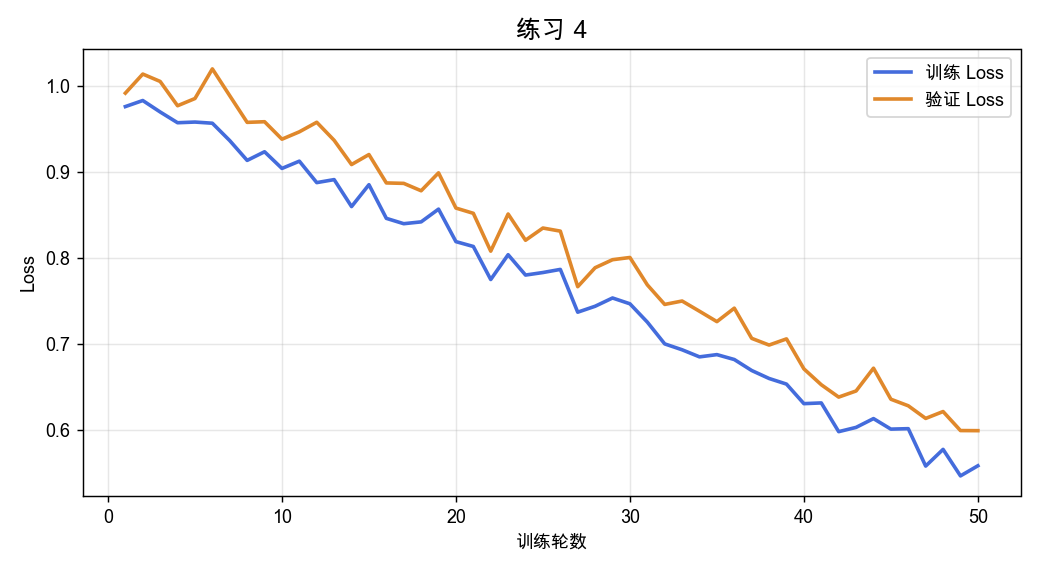
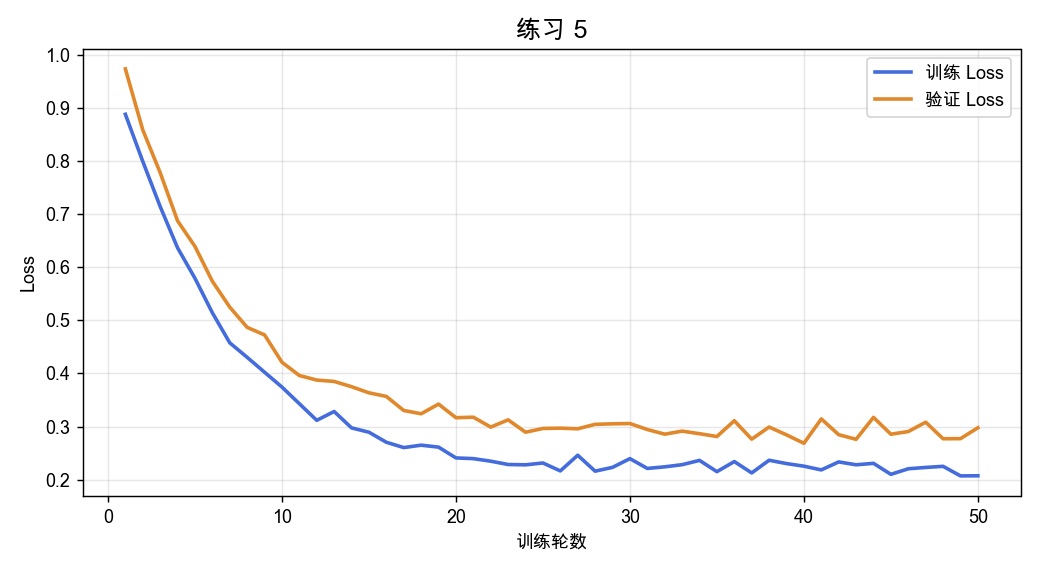
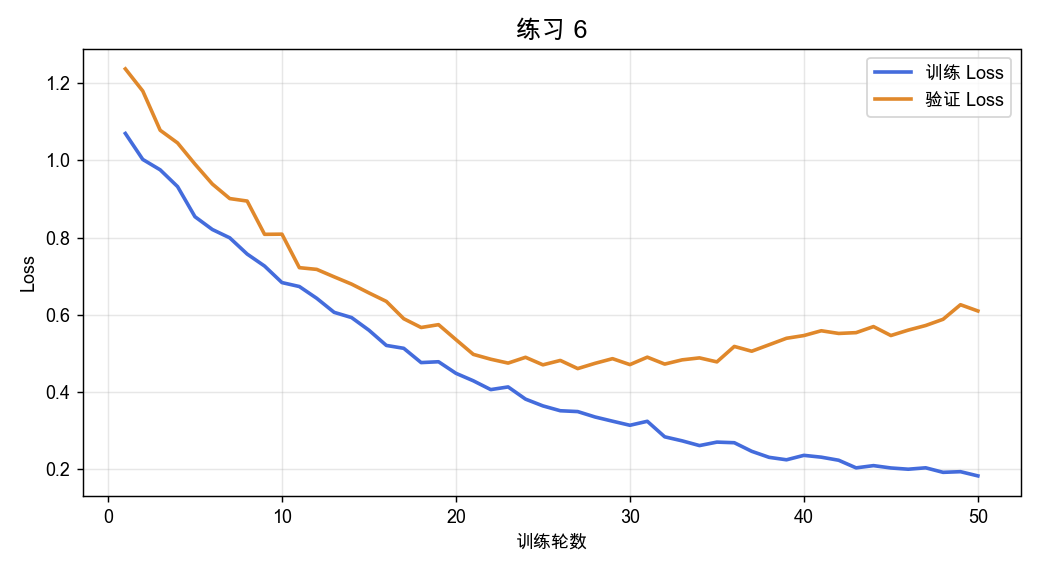
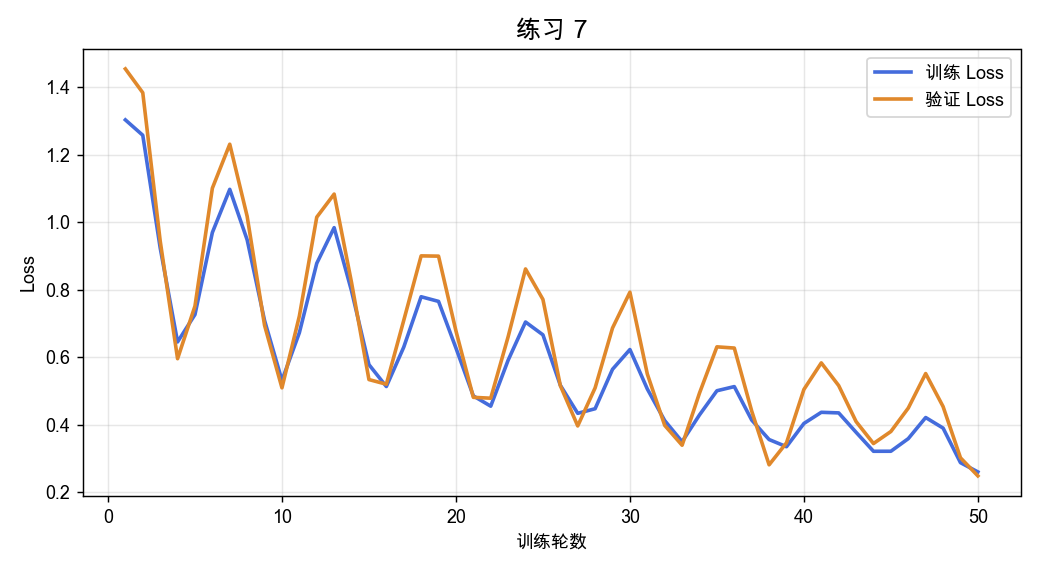
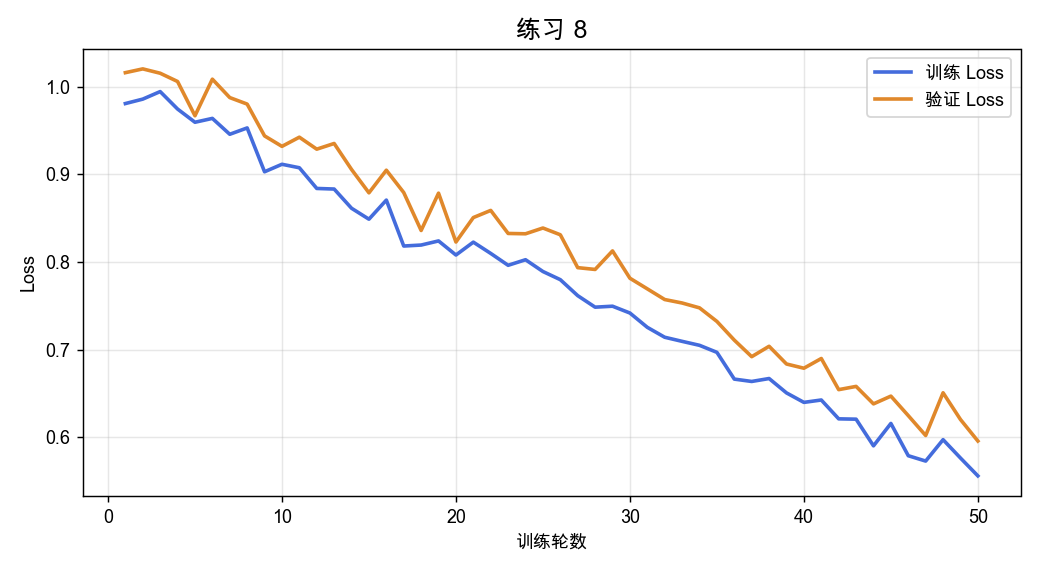
结果页的 Loss 曲线有两条线:蓝 = 训练(学过的数据上的误差),橙 = 验证(没见过的数据上的误差)。看三件事:两条线最后贴不贴、有没有降到底、抖不抖。
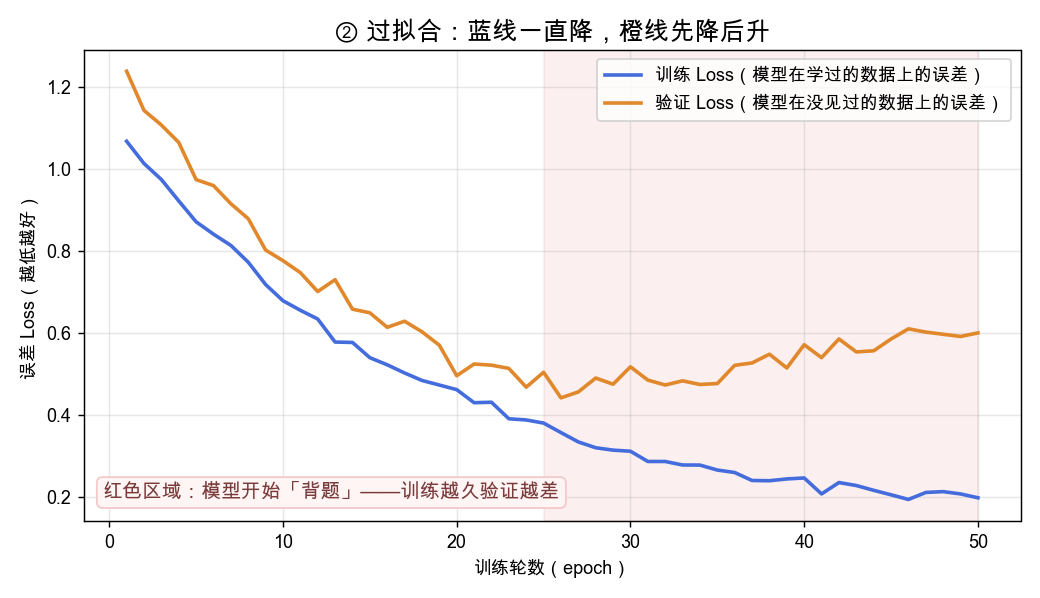
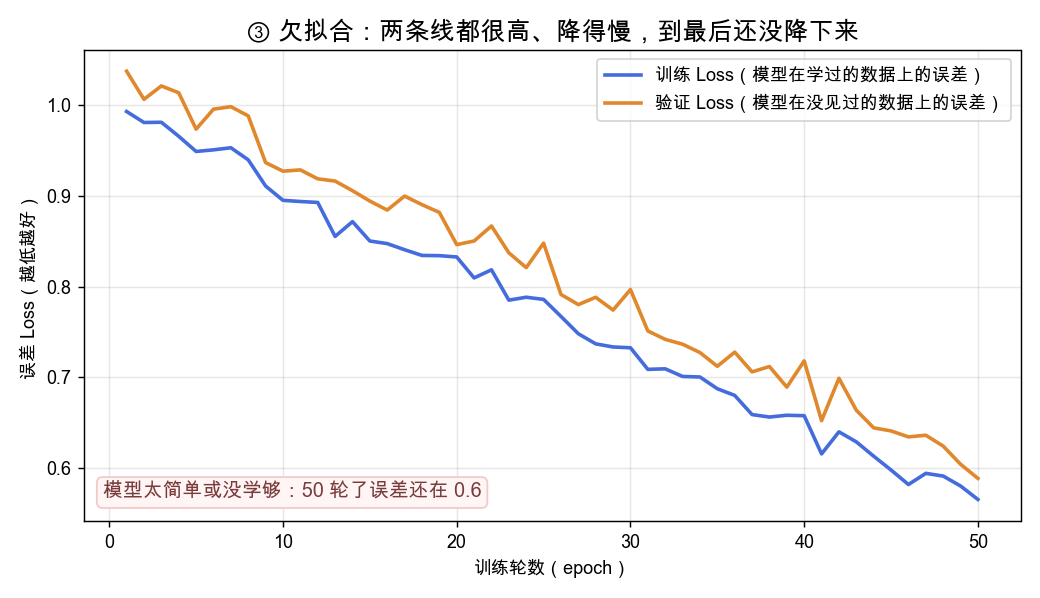
| 问题 | 曲线长什么样(看得见的) | 为什么 | 一句话记 |
|---|---|---|---|
| 过拟合 | 蓝线一直降,橙线先降后升,两条线越来越开 | 模型把训练数据背下来了,没见过的就不会 | 蓝降橙升 = 背题 |
| 欠拟合 | 两条线都很高、降得慢,到最后一轮还没降下来,但贴得近 | 模型太简单,或者没学够轮数 | 都高不降 = 没学够 |
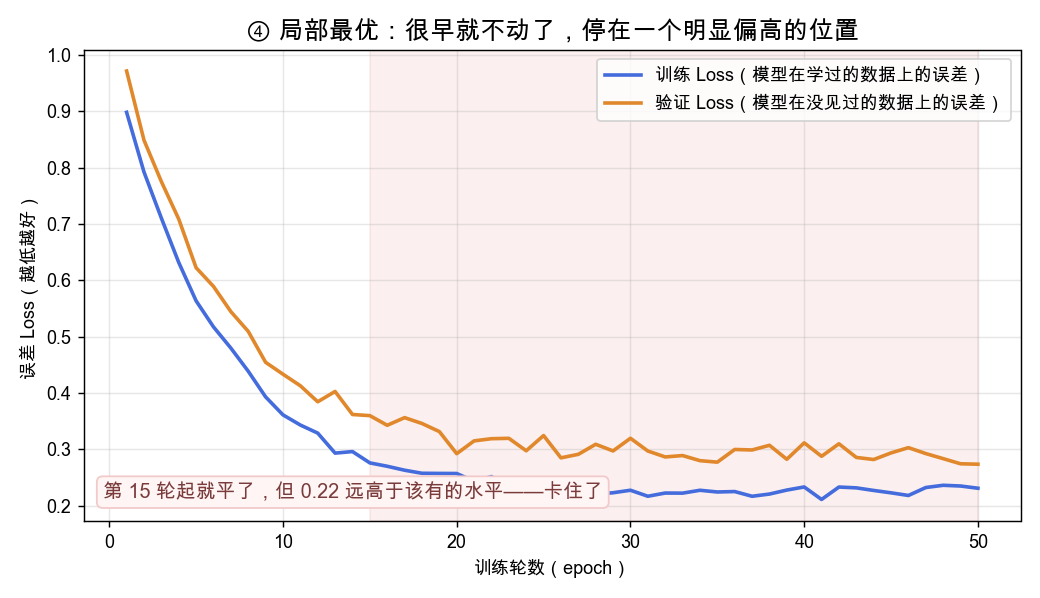
| 局部最优 | 很早就平了,停在一个明显偏高的位置不动 | 学习率太小走不出去,或优化器不合适 | 早平高位 = 卡住 |
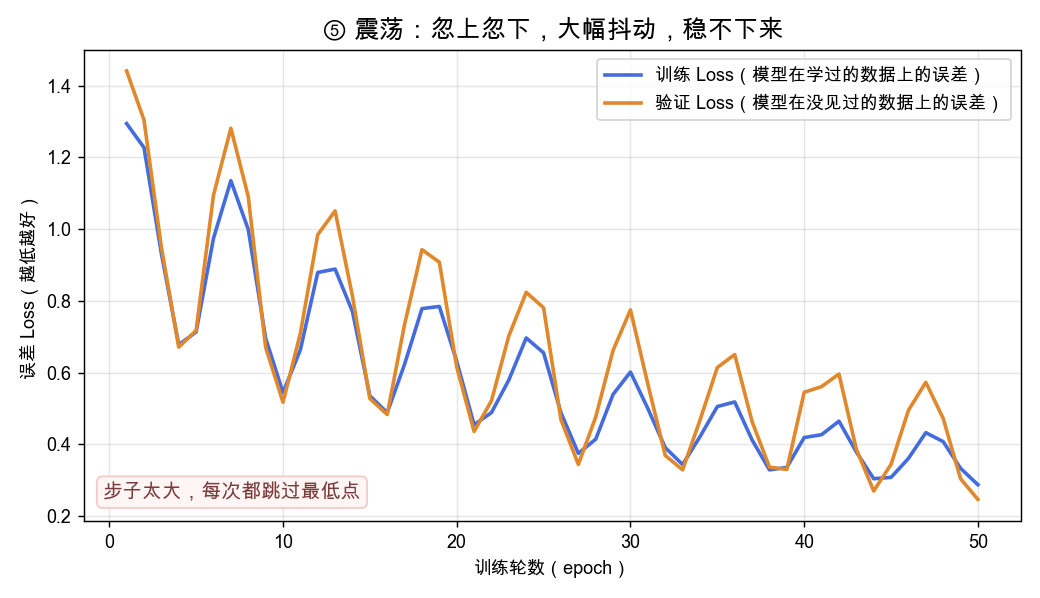
| 震荡 | 忽上忽下,大幅抖动,稳不下来 | 学习率太大,每步都跳过最低点 | 上下乱跳 = 步子大 |
答案解析给的方案,加上平台上对应的按钮。一次只改一处,改完重训看曲线。
| 问题 | 改什么(按优先级) | 平台上哪个框 | 举例 |
|---|---|---|---|
| 过拟合 | ① 减训练轮数 ② 减层数 ③ 减每层神经元 ④ 减树的深度 / 数量(XGBoost) | 训练轮数 ↓;隐藏层层数 ↓;神经元 ↓;决策树最大深度 ↓ | 轮数 100→50;层 3→2;深度 9→6 |
| 欠拟合 | ① 加训练轮数 ② 加层数 ③ 加每层神经元 ④ 加树的数量 / 深度 | 训练轮数 ↑;隐藏层层数 ↑;神经元 ↑;决策树数量 ↑ | 轮数 50→150;神经元 32→64;树 100→300 |
| 局部最优 | ① 加大学习率 ② 换优化器(平台没有,跳过) | 学习率 ↑ | 0.0001→0.001 |
| 震荡 | ① 降低学习率 ② 加大批次大小 | 学习率 ↓;批次大小 ↑ | 0.01→0.001;批 16→64 |
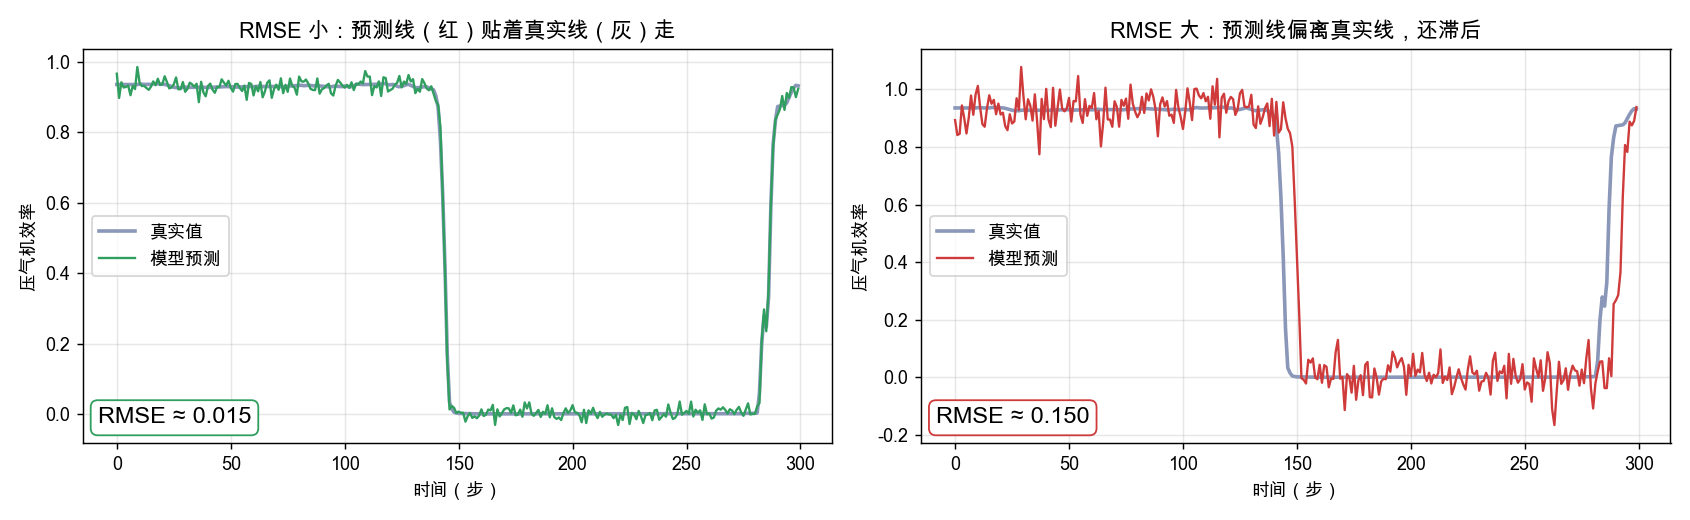
| 健康但 RMSE 还想更低 | 换时间步(24/48/96 之间);换模型对比 | 时间步长度;顶部模型按钮 | XGBoost 步 24 → LSTM 步 96 |
每张图先自己说:① 是哪种情况 ② 改哪个参数、往哪个方向。说完点开答案对。
时间步是 24 / 48 / 96 之一,不是随手填的数
至少跑了 XGBoost 和 LSTM 各一版做对比
每个版本只改了一处,历史版本里能说出每版为什么变
提交那版的 Loss 曲线是健康形状(一起降、贴近、不抖)
没有「看到过拟合还加轮数」这种反向操作