华电新疆公司 · 集团 AI 竞赛赛前培训 · 第二天 · 模型调优

模型调优(一)· 题型解读、模型选型与平台建模流程

上午课配套材料:先读题与数据,然后照着平台界面一步一步走:每一步界面上有什么、该选什么、为什么、举例说明。界面可点击:点模型按钮切换参数表、点参数框、点曲线、点版本行,右侧都会给出说明;素材文件可直接点开查看。

素材:样题《模型调优》题干与答案解析 + train.csv + 平台截图对应日程:10/20 上午 10:00-11:30

1题目是什么:压气机效率预测

先把题读完,再看它到底要我们干什么。

题目背景(摘要)
燃气轮机的压气机是核心部件,它的效率直接决定整台机组省不省油。效率受很多因素影响,
传统物理仿真算得准但太慢。现在用历史运行数据训练一个模型,让它根据最近一段时间的
运行参数,预测下一时刻的压气机效率。

题目要求
1. 基于提供的压气机效率数据集,构建机器学习或深度学习模型,实现对压气机效率的高精度预测;
2. 根据训练过程中的指标调整模型超参数(学习率、迭代次数、优化器、时间步长度、网络层数、
   每层神经元个数、batch size 等),以获得更优结果;
3. 评分采用独立数据集,考生需确保模型的泛化性能。
注:系统按考生要求的时间步长度构造训练数据集,进行单步时间序列预测。

评分标准
预测可靠性  权重 0.8  推理效率  权重 0.2
题目要求概括给模型看过去 N 个时刻的 7 个参数,让它猜下一个时刻的「压气机效率」是多少。猜得越准分越高(0.8),算得越快分越高(0.2)。
我们要做的事只有三件① 在平台上选一个模型 ② 填几个参数、点开始训练 ③ 看曲线判断效果,不理想就改参数再训一次。
「泛化性能」是什么评分用的是我们没见过的数据。模型只会「背」训练数据不行,要能举一反三。下午课讲的「过拟合」就是这种情况。
「单步预测」是什么只预测下一个点(5 分钟后),不是预测一天。所以模型不用特别复杂。

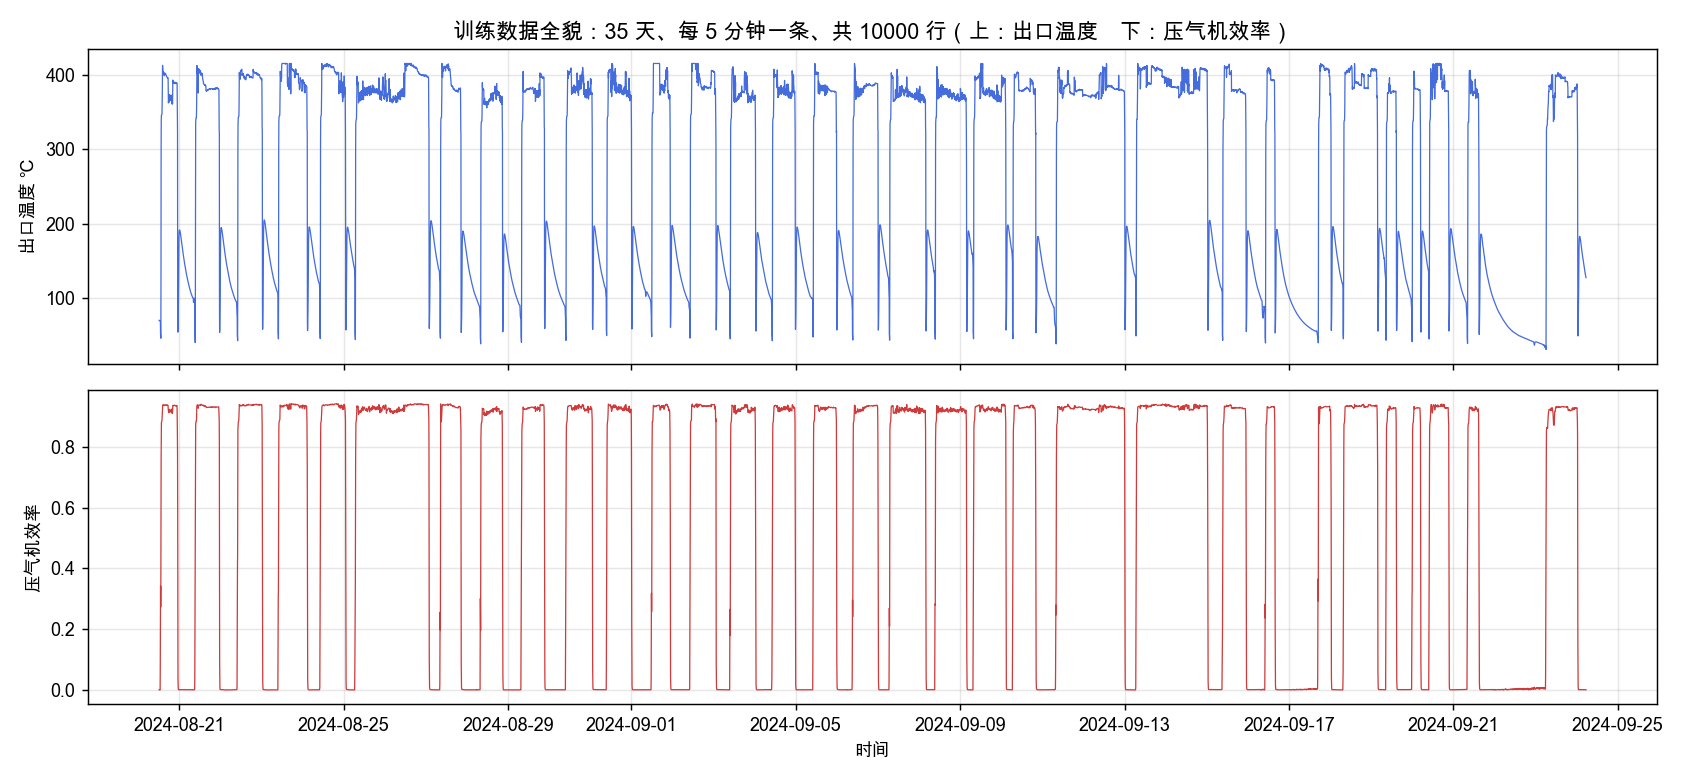
2先把数据看明白:35 天、每 5 分钟一条

调参之前先看数据长什么样——周期是几天、有没有缺口。这一步决定后面「时间步」怎么填。

数据文件train.csv,10000 行 × 8 列
时间范围2024-08-20 12:10 → 2024-09-24 05:25,共 35 天
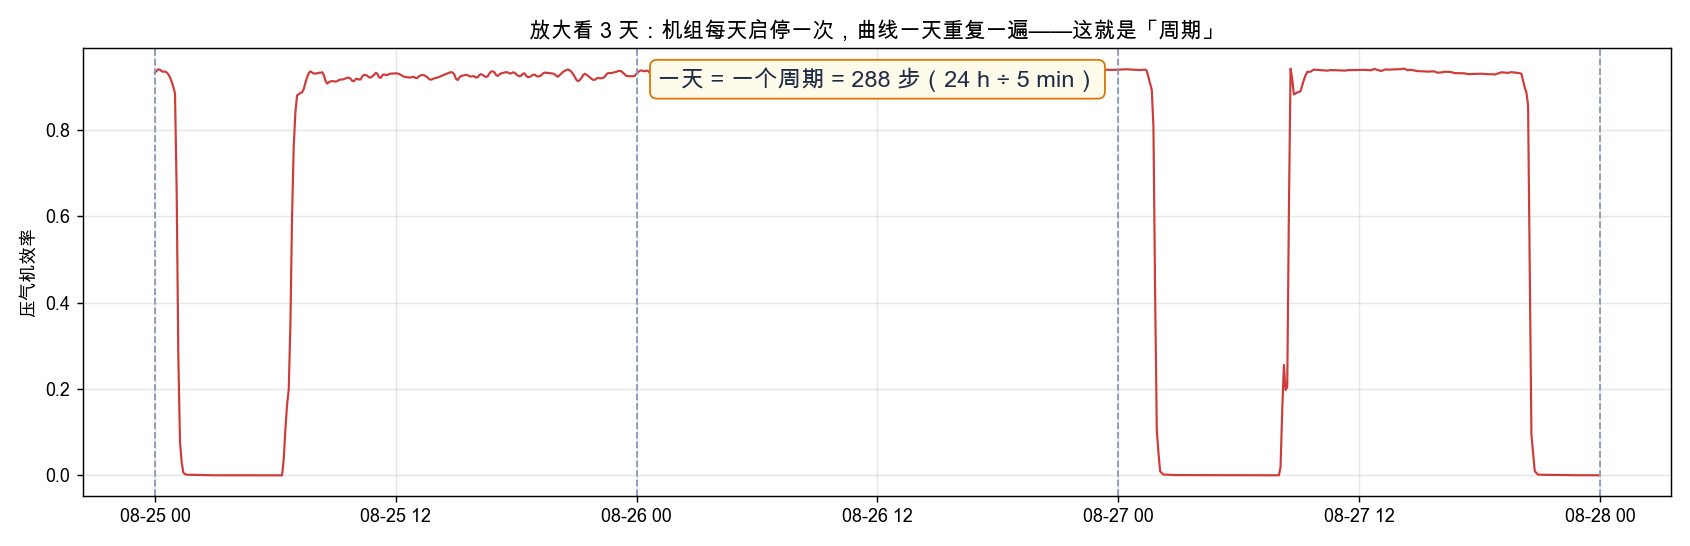
采样间隔每 5 分钟一条,中间没有缺口(1 天 = 288 条)
7 个输入列进口温度 / 出口温度 / 压比 / 大气压力 / IGV 角度 / 滤网压差 / 时间
1 个要预测的列压气机效率(0~0.94,停机时为 0)

素材文件(点击直接打开)

图 2-1 35 天全貌:机组每天启停一次,曲线一天一个「坑」
图 2-2 放大 3 天:每天的形状几乎一样——这叫「周期」,周期 = 1 天 = 288 个点
平台上怎么看:第 3 节第一步里的「图表分析」。

3模拟平台:左边照着点,右边跟着讲

下面是一个可以操作的模拟赛场平台。左边是界面——点「开始答题」「开始训练」「提交」会真的翻页,点模型 / 参数框 / 曲线 / 版本行都有反应;右边是解说——你点到哪,它就讲哪。从头到尾点一遍,就等于把题做了一遍。

① 进题目→② 选模型 · 填参数→③ 训练中→④ 看结果→⑤ 历史版本→⑥ 已提交点这里也能跳页
AI 大赛 | 参赛入口 · 模型调优http://10.168.157.18:32572/… ⟲ 历史版本
题干 ① 点下面题干 · 看怎么读
题目背景
在现代燃气轮机系统中,压气机作为核心部件,其性能直接决定整个机组的热效率、运行稳定性和经济性。压气机效率是衡量能量转换能力的关键指标,哪怕微小的效率提升,也能带来显著的燃料节省与碳排放下降。然而,压气机内部流动过程高度复杂,涉及多物理场耦合、非定常流动、边界层分离等强非线性现象。传统基于物理模型的预测方法(如 CFD 仿真)虽然精度较高,但计算代价巨大,难以满足实时性需求。伴随人工智能与大数据技术的发展,数据驱动的智能建模方法为压气机性能预测开辟了新路径。构建高精度、高效率的机器学习模型,可在保证预测准确性的同时大幅缩短计算时间,支撑实时监测、故障预警与运行优化。因此,基于实际运行数据开展压气机效率智能预测研究,不仅具有重要的工程应用价值,也是推动能源装备智能化升级的关键突破口。

题目要求
考生需基于所提供的燃机压气机效率数据集,构建机器学习或深度学习模型,实现对压气机效率的高精度预测;
请根据训练过程中的指标调整模型超参数(如学习率、迭代次数、优化器、时间步长度、网络层数、每层神经元个数、batch size 等),以获得更优结果;
评分采用独立数据集,考生需确保模型的泛化性能。
注:系统按照考生要求的时间步长度构造训练数据集,进行单步时间序列预测。

评分标准
预测可靠性 权重 0.8 | 推理效率 权重 0.2
数据集 ② 点下面表格 · 看有哪些列 查看训练数据 ↗ 图表分析③ 点「图表分析」· 看周期
时间进口温度出口温度压比大气压力IGV角度滤网压差压气机效率
2024-08-20 12:1037.0370.191.00751.6520.24-2.500.0003
2024-08-20 12:1537.1069.731.00751.6320.25-2.490.0005
2024-08-20 12:2037.1669.601.00751.6520.25-2.500.0008
2024-08-20 12:2537.2469.501.00751.6320.26-2.540.0011
……共 10000 行
开始答题④ 三件事做完点「开始答题」
点击查看 训练数据,选择合适的模型运行。
选择要使用的模型:① 点一个模型
通用参数 ② 点任一参数框
XGBoost 特有参数
开始训练 ⏻③ 填好点「开始训练」全部重置 ↺
正在训练 XGBoost……
构造时间步窗口 → 切分训练 / 验证集 → 逐轮训练 → 计算指标
四张曲线 点任一张 · 右边讲它是什么
Loss 曲线
— 训练— 验证
RMSE 曲线
SMAPE 曲线
MASE 曲线
提交此版本返回调参⟲ 历史版本
版本列表 点任一行 · 看这版为什么留 / 弃
版本模型参数验证 RMSE用时状态
v1XGBoostlr 0.05 / 占比 0.8 / 步 24 / 树 200 / 深 60.04101:38基线
v2XGBoost同 v1,树 400 / 深 90.04303:20略差且慢
v3LSTMlr 0.001 / 批 32 / 轮 50 / 占比 0.8 / 步 96 / 2×640.03805:12最优
v4LSTM同 v3,轮 1000.046 ↑09:05过拟合
v5LSTM同 v3,学习率 0.010.07105:08震荡
查看曲线回到这组参数提交选中版本
✔
已提交 v3 · LSTM
系统将用独立数据集评分:预测可靠性 0.8 + 推理效率 0.2
从头再走一遍

界面依据客户提供的平台截图绘制,位置可能略有出入;真实截图:题干 | 数据集 | LSTM 调参 | XGBoost 调参 | Loss+RMSE | SMAPE+MASE

4完整走一遍:赛场推荐顺序

  1. 进题目(1 分钟):读题圈三个词;点「图表分析」看周期 = 288。
  2. v1 XGBoost:学习率 0.05 / 占比 0.8 / 时间步 24 / 树 200 / 深 6 → 训练 → 看 Loss、RMSE 曲线是否健康 → 记下 RMSE 和用时。
  3. v2 LSTM:学习率 0.001 / 批 32 / 轮 50 / 占比 0.8 / 时间步 96 / 2 层 × 64 → 训练 → 对比 v1。
  4. 哪个有问题改哪个(下午课对症调参表),一次只改一处,每版记一行。
  5. 历史版本里挑:RMSE 最低的提交;差不多选用时短的。

时间步是 24 / 48 / 96 之一,不是随手填的数

至少跑了 XGBoost 和 LSTM 各一版做对比

每个版本只改了一处,能说出每版为什么变

提交那版的 Loss 曲线是健康形状(一起降、贴近、不抖)

口径:基于客户提供的样题与平台截图编写,界面为示意,实际以赛场版本为准;无平台实操环境,本日为理论与案例讲解。